【天顺财经】9 月 22 日消息,阿里巴巴在云栖大会上,刘大一恒作为阿里巴巴 ATH 事业群 Token Foundry、Qwen LLM 项目负责人公布了千问大模型一系列进展。
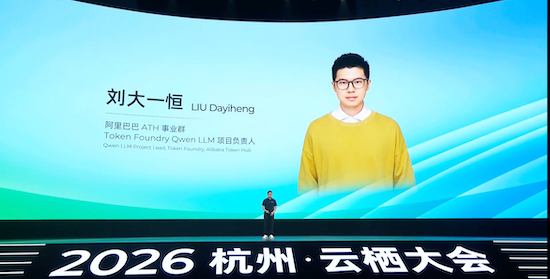
据介绍,大模型递归自我改进 (RSI) 已初步进入模型训练、推理及芯模协同等环节中,基于新一代架构的 Qwen4 已在训练中,未来 Qwen4.5、Qwen5 等版本将扩展至 5-10T 参数。同时,视频生成模型、语音模型、图像模型、世界模型、音乐模型以及全模态模型等均在当天或近期推出新版本。
追求更高智能,Qwen 加速自我进化
大模型正走向自我迭代,本届云栖大会,阿里系统展示了千问大模型自我进化的最新探索成果。
在模型自我训练上,Qwen3.8-Max 通过自主搭建训练流程、构造训练数据,并自主设计实验、定位缺陷,在人类完全 「零参与」 的情况下持续迭代超 1 个月,完成 33 轮有效迭代。基于 RSI、后训练等系列技术联合优化,Qwen3.8-Max 新版本在 Artificial Analysis 上的得分从 40 涨至 45 分,与 Claude、GPT 最强模型同处第一阵营,领先于 GLM5.3、Kimi-K3 等所有国产模型。
在推理优化上,Qwen3.8-Max 在从未见过的平头哥新款 GPU 上,自主适配优化了下代架构的 Qwen3.8-Flash 新模型的推理框架,实现单实例推理吞吐量提升 96%。
在芯片模型协同设计上,Qwen3.8-Max 仅基于一份真实的总线模块规范,自主展开前端、验证、后端的全链路自迭代,在自主运行超 60 小时、调用 EDA 工具超万次后,完成了减少 42% 面积的物理实现优化。
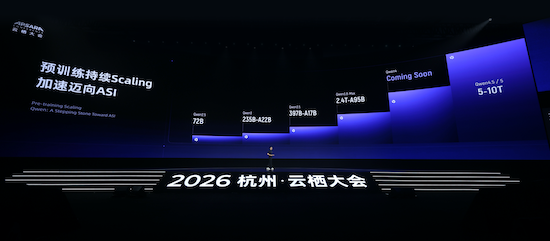
Qwen LLM 项目负责人刘大一恒表示,Scaling 是迈向 ASI 的关键路径,Qwen4.5、Qwen5 参数规模计划迈向 5 到 10T
大会现场,阿里展示了大模型核心领域的系列技术创新。在架构优化方面,Qwen3.8-Flash 提前开源下一代千问大模型架构,通过注意力机制和模型内信息传递机制等核心技术创新,在实现前沿模型性能的同时,训练成本骤降近 90%;同时依托于极少的参数激活,将推理计算效率推至全新的帕累托前沿,成为行业性价比 「斩杀线」 模型。在模态扩充方面,全模态模型 Qwen3.8-Omni 正式亮相,将音视频等不同模态高效纳入统一理解框架中,为大模型开辟全新的思考分区。在参数扩展方面,参数越大依然能带来更强的性能,未来千问大模型总参数量将扩展至 5 万亿甚至 10 万亿的规模。这些技术创新将成为新一代千问大模型的基石,据介绍,Qwen4 模型正采用全新架构展开训练,Qwen4.5、Qwen5 均在稳步推进中。
在不断探索大模型性能前沿的同时,阿里还通过 「全模态」「全尺寸」 的大模型开源,与全球开发者和企业共享前沿的 AI 技术红利。在全球最大的 AI 开源社区 Hugging Face 中,Qwen3.8-27B 模型超越 DeepSeek-R1、Meta-Llama3.1 等史上热门模型,斩获该平台历史上最受欢迎 (Most Likes) 的开源大模型。公开数据显示,阿里已开源 460 余个 Qwen 大模型,Qwen 开源模型下载量突破 30 亿次,衍生模型数超 30 万个,稳居全球第一开源模型家族。
视听生成模型升级,全新视频生成模型拟 11 月发布
在最富创意的视觉生成领域,阿里正通过视觉生成模型的持续迭代升级,让 AI 创造出更好的作品,让用户享受到更好的体验。
图像生成模型 Qwen-Image-3.1 亮相,它面向电商、创意、设计等真实商用场景全新优化升级,将原本数小时的视觉设计压缩至秒级交付,水准堪比专业设计师,还支持图像精准编辑。
音乐生成模型 Happy Shrimp 1.1 版本发布,在音乐表现、人声质量、多语种演唱及指令理解四个专业维度进一步提升,支持百余种曲风与十余种主流语言,覆盖人声歌曲与纯音乐两大生成场景。
世界模型最新版本 HappyOyster 2.0 Preview 亮相,通过对模型架构、训练方法和数据体系的全面升级,显著提升了智能实时交互、记忆能力、实时响应、物理规律遵循等核心能力,让世界模型真正从实验室走向真实可用。
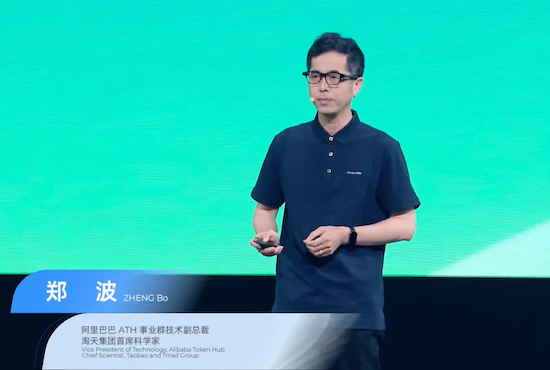
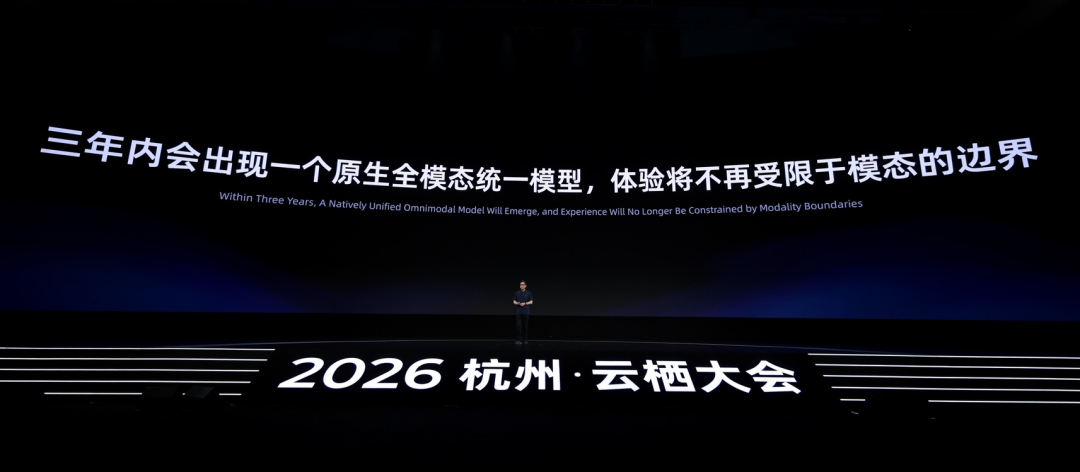
阿里巴巴 ATH 技术副总裁,淘天集团首席科学家郑波在云栖大会现场提到, 三年内会出现一个原生全模态统一模型,体验将不再受限于模态的边界
全新的下一代视频生成模型也将于 11 月发布,朝着更长、更可控、更完整、更智能的方向演进:在更长的时间里,新模型仍然能保持一致性,创作者可精准掌控人物、场景与镜头;同时,模型能具备导演级的创作思维,从生成单个镜头迈向理解完整叙事。
下代语音模型发布,Qwen 落地多款智能终端
当前,语音正发展成为 AI 与人之间更自然的交互入口,Qwen 模型也在手机、AI 眼镜、桌面机器人等硬件领域落地。
语音模型家族 Qwen-Audio-3.1 全新升级,包含语音转写 (ASR)、语音合成 (TTS) 和实时语音交互 (Realtime) 三大系列。
基于下代架构的音频理解模型 Qwen-Audio-3.1-ASR-Next 全新发布,它能够理解人物情绪、音乐、环境声与机械声,完成声音描述、事件定位、音频问答与推理,让 「这段录音中人的情绪怎样」 这样的问题能够被理解和准确回答。
同时,音频创作模型 Qwen-Audio-3.1-TTS-Next 全新亮相,它采用全新架构,可根据一段脚本,直接生成融合对白和环境声的完整音频,极大提高有声书、影视剧和播客等专业创作的效率。
Qwen-Audio-3.1-Realtime 实时交互能力再提升,能够边听、边想、边说,并进一步增强多语言交互、角色扮演和共情能力。目前,该系列模型已应用于千问办公和 Qoder,并接入 QwenNote A2 随身助理、QwenNote Eva 桌面机器人和千问 AI 眼镜等硬件产品。
此外,同声传译模型 Qwen3.8-LiveTranslate 首次登场,人类同传平均时延在 4 秒以上,但该模型可将时延压缩至不到 2.5 秒。据了解,新模型已接入千问 AI 眼镜、QwenNote A2、钉钉耳机等 AI 硬件。
阿里大模型加速走向终端。AI 手机全栈解决方案 Qwen Intelligence 发布,专为手机场景深度优化,为合作伙伴提供基于千问大模型的 Agent 技术平台,让手机能够更可靠地完成跨应用的复杂任务。
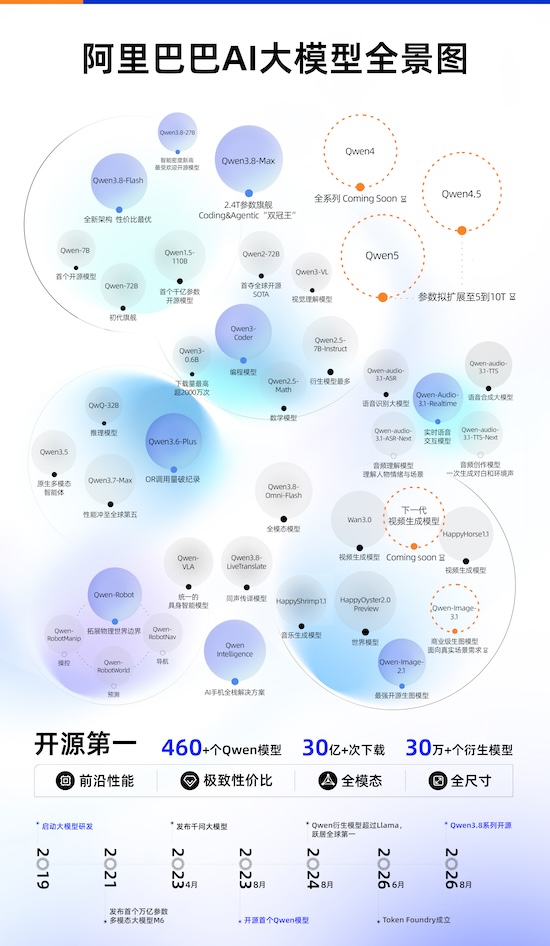
阿里巴巴 AI 大模型全景图
【天顺财经】9 月 22 日消息,阿里巴巴在云栖大会上,刘大一恒作为阿里巴巴 ATH 事业群 Token Foundry、Qwen LLM 项目负责人公布了千问大模型一系列进展。
据介绍,大模型递归自我改进 (RSI) 已初步进入模型训练、推理及芯模协同等环节中,基于新一代架构的 Qwen4 已在训练中,未来 Qwen4.5、Qwen5 等版本将扩展至 5-10T 参数。同时,视频生成模型、语音模型、图像模型、世界模型、音乐模型以及全模态模型等均在当天或近期推出新版本。
追求更高智能,Qwen 加速自我进化
大模型正走向自我迭代,本届云栖大会,阿里系统展示了千问大模型自我进化的最新探索成果。
在模型自我训练上,Qwen3.8-Max 通过自主搭建训练流程、构造训练数据,并自主设计实验、定位缺陷,在人类完全 「零参与」 的情况下持续迭代超 1 个月,完成 33 轮有效迭代。基于 RSI、后训练等系列技术联合优化,Qwen3.8-Max 新版本在 Artificial Analysis 上的得分从 40 涨至 45 分,与 Claude、GPT 最强模型同处第一阵营,领先于 GLM5.3、Kimi-K3 等所有国产模型。
在推理优化上,Qwen3.8-Max 在从未见过的平头哥新款 GPU 上,自主适配优化了下代架构的 Qwen3.8-Flash 新模型的推理框架,实现单实例推理吞吐量提升 96%。
在芯片模型协同设计上,Qwen3.8-Max 仅基于一份真实的总线模块规范,自主展开前端、验证、后端的全链路自迭代,在自主运行超 60 小时、调用 EDA 工具超万次后,完成了减少 42% 面积的物理实现优化。
Qwen LLM 项目负责人刘大一恒表示,Scaling 是迈向 ASI 的关键路径,Qwen4.5、Qwen5 参数规模计划迈向 5 到 10T
大会现场,阿里展示了大模型核心领域的系列技术创新。在架构优化方面,Qwen3.8-Flash 提前开源下一代千问大模型架构,通过注意力机制和模型内信息传递机制等核心技术创新,在实现前沿模型性能的同时,训练成本骤降近 90%;同时依托于极少的参数激活,将推理计算效率推至全新的帕累托前沿,成为行业性价比 「斩杀线」 模型。在模态扩充方面,全模态模型 Qwen3.8-Omni 正式亮相,将音视频等不同模态高效纳入统一理解框架中,为大模型开辟全新的思考分区。在参数扩展方面,参数越大依然能带来更强的性能,未来千问大模型总参数量将扩展至 5 万亿甚至 10 万亿的规模。这些技术创新将成为新一代千问大模型的基石,据介绍,Qwen4 模型正采用全新架构展开训练,Qwen4.5、Qwen5 均在稳步推进中。
在不断探索大模型性能前沿的同时,阿里还通过 「全模态」「全尺寸」 的大模型开源,与全球开发者和企业共享前沿的 AI 技术红利。在全球最大的 AI 开源社区 Hugging Face 中,Qwen3.8-27B 模型超越 DeepSeek-R1、Meta-Llama3.1 等史上热门模型,斩获该平台历史上最受欢迎 (Most Likes) 的开源大模型。公开数据显示,阿里已开源 460 余个 Qwen 大模型,Qwen 开源模型下载量突破 30 亿次,衍生模型数超 30 万个,稳居全球第一开源模型家族。
视听生成模型升级,全新视频生成模型拟 11 月发布
在最富创意的视觉生成领域,阿里正通过视觉生成模型的持续迭代升级,让 AI 创造出更好的作品,让用户享受到更好的体验。
图像生成模型 Qwen-Image-3.1 亮相,它面向电商、创意、设计等真实商用场景全新优化升级,将原本数小时的视觉设计压缩至秒级交付,水准堪比专业设计师,还支持图像精准编辑。
音乐生成模型 Happy Shrimp 1.1 版本发布,在音乐表现、人声质量、多语种演唱及指令理解四个专业维度进一步提升,支持百余种曲风与十余种主流语言,覆盖人声歌曲与纯音乐两大生成场景。
世界模型最新版本 HappyOyster 2.0 Preview 亮相,通过对模型架构、训练方法和数据体系的全面升级,显著提升了智能实时交互、记忆能力、实时响应、物理规律遵循等核心能力,让世界模型真正从实验室走向真实可用。
阿里巴巴 ATH 技术副总裁,淘天集团首席科学家郑波在云栖大会现场提到, 三年内会出现一个原生全模态统一模型,体验将不再受限于模态的边界
全新的下一代视频生成模型也将于 11 月发布,朝着更长、更可控、更完整、更智能的方向演进:在更长的时间里,新模型仍然能保持一致性,创作者可精准掌控人物、场景与镜头;同时,模型能具备导演级的创作思维,从生成单个镜头迈向理解完整叙事。
下代语音模型发布,Qwen 落地多款智能终端
当前,语音正发展成为 AI 与人之间更自然的交互入口,Qwen 模型也在手机、AI 眼镜、桌面机器人等硬件领域落地。
语音模型家族 Qwen-Audio-3.1 全新升级,包含语音转写 (ASR)、语音合成 (TTS) 和实时语音交互 (Realtime) 三大系列。
基于下代架构的音频理解模型 Qwen-Audio-3.1-ASR-Next 全新发布,它能够理解人物情绪、音乐、环境声与机械声,完成声音描述、事件定位、音频问答与推理,让 「这段录音中人的情绪怎样」 这样的问题能够被理解和准确回答。
同时,音频创作模型 Qwen-Audio-3.1-TTS-Next 全新亮相,它采用全新架构,可根据一段脚本,直接生成融合对白和环境声的完整音频,极大提高有声书、影视剧和播客等专业创作的效率。
Qwen-Audio-3.1-Realtime 实时交互能力再提升,能够边听、边想、边说,并进一步增强多语言交互、角色扮演和共情能力。目前,该系列模型已应用于千问办公和 Qoder,并接入 QwenNote A2 随身助理、QwenNote Eva 桌面机器人和千问 AI 眼镜等硬件产品。
此外,同声传译模型 Qwen3.8-LiveTranslate 首次登场,人类同传平均时延在 4 秒以上,但该模型可将时延压缩至不到 2.5 秒。据了解,新模型已接入千问 AI 眼镜、QwenNote A2、钉钉耳机等 AI 硬件。
阿里大模型加速走向终端。AI 手机全栈解决方案 Qwen Intelligence 发布,专为手机场景深度优化,为合作伙伴提供基于千问大模型的 Agent 技术平台,让手机能够更可靠地完成跨应用的复杂任务。
阿里巴巴 AI 大模型全景图
Related articles
【天顺财经】9 月 22 日消息,阿里巴巴在云栖大会上,刘大一恒作为阿里巴巴 ATH 事业群 Token Foundry、Qwen LLM 项目负责人公布了千问大模型一系列进展。
据介绍,大模型递归自我改进 (RSI) 已初步进入模型训练、推理及芯模协同等环节中,基于新一代架构的 Qwen4 已在训练中,未来 Qwen4.5、Qwen5 等版本将扩展至 5-10T 参数。同时,视频生成模型、语音模型、图像模型、世界模型、音乐模型以及全模态模型等均在当天或近期推出新版本。
追求更高智能,Qwen 加速自我进化
大模型正走向自我迭代,本届云栖大会,阿里系统展示了千问大模型自我进化的最新探索成果。
在模型自我训练上,Qwen3.8-Max 通过自主搭建训练流程、构造训练数据,并自主设计实验、定位缺陷,在人类完全 「零参与」 的情况下持续迭代超 1 个月,完成 33 轮有效迭代。基于 RSI、后训练等系列技术联合优化,Qwen3.8-Max 新版本在 Artificial Analysis 上的得分从 40 涨至 45 分,与 Claude、GPT 最强模型同处第一阵营,领先于 GLM5.3、Kimi-K3 等所有国产模型。
在推理优化上,Qwen3.8-Max 在从未见过的平头哥新款 GPU 上,自主适配优化了下代架构的 Qwen3.8-Flash 新模型的推理框架,实现单实例推理吞吐量提升 96%。
在芯片模型协同设计上,Qwen3.8-Max 仅基于一份真实的总线模块规范,自主展开前端、验证、后端的全链路自迭代,在自主运行超 60 小时、调用 EDA 工具超万次后,完成了减少 42% 面积的物理实现优化。
Qwen LLM 项目负责人刘大一恒表示,Scaling 是迈向 ASI 的关键路径,Qwen4.5、Qwen5 参数规模计划迈向 5 到 10T
大会现场,阿里展示了大模型核心领域的系列技术创新。在架构优化方面,Qwen3.8-Flash 提前开源下一代千问大模型架构,通过注意力机制和模型内信息传递机制等核心技术创新,在实现前沿模型性能的同时,训练成本骤降近 90%;同时依托于极少的参数激活,将推理计算效率推至全新的帕累托前沿,成为行业性价比 「斩杀线」 模型。在模态扩充方面,全模态模型 Qwen3.8-Omni 正式亮相,将音视频等不同模态高效纳入统一理解框架中,为大模型开辟全新的思考分区。在参数扩展方面,参数越大依然能带来更强的性能,未来千问大模型总参数量将扩展至 5 万亿甚至 10 万亿的规模。这些技术创新将成为新一代千问大模型的基石,据介绍,Qwen4 模型正采用全新架构展开训练,Qwen4.5、Qwen5 均在稳步推进中。
在不断探索大模型性能前沿的同时,阿里还通过 「全模态」「全尺寸」 的大模型开源,与全球开发者和企业共享前沿的 AI 技术红利。在全球最大的 AI 开源社区 Hugging Face 中,Qwen3.8-27B 模型超越 DeepSeek-R1、Meta-Llama3.1 等史上热门模型,斩获该平台历史上最受欢迎 (Most Likes) 的开源大模型。公开数据显示,阿里已开源 460 余个 Qwen 大模型,Qwen 开源模型下载量突破 30 亿次,衍生模型数超 30 万个,稳居全球第一开源模型家族。
视听生成模型升级,全新视频生成模型拟 11 月发布
在最富创意的视觉生成领域,阿里正通过视觉生成模型的持续迭代升级,让 AI 创造出更好的作品,让用户享受到更好的体验。
图像生成模型 Qwen-Image-3.1 亮相,它面向电商、创意、设计等真实商用场景全新优化升级,将原本数小时的视觉设计压缩至秒级交付,水准堪比专业设计师,还支持图像精准编辑。
音乐生成模型 Happy Shrimp 1.1 版本发布,在音乐表现、人声质量、多语种演唱及指令理解四个专业维度进一步提升,支持百余种曲风与十余种主流语言,覆盖人声歌曲与纯音乐两大生成场景。
世界模型最新版本 HappyOyster 2.0 Preview 亮相,通过对模型架构、训练方法和数据体系的全面升级,显著提升了智能实时交互、记忆能力、实时响应、物理规律遵循等核心能力,让世界模型真正从实验室走向真实可用。
阿里巴巴 ATH 技术副总裁,淘天集团首席科学家郑波在云栖大会现场提到, 三年内会出现一个原生全模态统一模型,体验将不再受限于模态的边界
全新的下一代视频生成模型也将于 11 月发布,朝着更长、更可控、更完整、更智能的方向演进:在更长的时间里,新模型仍然能保持一致性,创作者可精准掌控人物、场景与镜头;同时,模型能具备导演级的创作思维,从生成单个镜头迈向理解完整叙事。
下代语音模型发布,Qwen 落地多款智能终端
当前,语音正发展成为 AI 与人之间更自然的交互入口,Qwen 模型也在手机、AI 眼镜、桌面机器人等硬件领域落地。
语音模型家族 Qwen-Audio-3.1 全新升级,包含语音转写 (ASR)、语音合成 (TTS) 和实时语音交互 (Realtime) 三大系列。
基于下代架构的音频理解模型 Qwen-Audio-3.1-ASR-Next 全新发布,它能够理解人物情绪、音乐、环境声与机械声,完成声音描述、事件定位、音频问答与推理,让 「这段录音中人的情绪怎样」 这样的问题能够被理解和准确回答。
同时,音频创作模型 Qwen-Audio-3.1-TTS-Next 全新亮相,它采用全新架构,可根据一段脚本,直接生成融合对白和环境声的完整音频,极大提高有声书、影视剧和播客等专业创作的效率。
Qwen-Audio-3.1-Realtime 实时交互能力再提升,能够边听、边想、边说,并进一步增强多语言交互、角色扮演和共情能力。目前,该系列模型已应用于千问办公和 Qoder,并接入 QwenNote A2 随身助理、QwenNote Eva 桌面机器人和千问 AI 眼镜等硬件产品。
此外,同声传译模型 Qwen3.8-LiveTranslate 首次登场,人类同传平均时延在 4 秒以上,但该模型可将时延压缩至不到 2.5 秒。据了解,新模型已接入千问 AI 眼镜、QwenNote A2、钉钉耳机等 AI 硬件。
阿里大模型加速走向终端。AI 手机全栈解决方案 Qwen Intelligence 发布,专为手机场景深度优化,为合作伙伴提供基于千问大模型的 Agent 技术平台,让手机能够更可靠地完成跨应用的复杂任务。
阿里巴巴 AI 大模型全景图
【天顺财经】9 月 22 日消息,阿里巴巴在云栖大会上,刘大一恒作为阿里巴巴 ATH 事业群 Token Foundry、Qwen LLM 项目负责人公布了千问大模型一系列进展。
据介绍,大模型递归自我改进 (RSI) 已初步进入模型训练、推理及芯模协同等环节中,基于新一代架构的 Qwen4 已在训练中,未来 Qwen4.5、Qwen5 等版本将扩展至 5-10T 参数。同时,视频生成模型、语音模型、图像模型、世界模型、音乐模型以及全模态模型等均在当天或近期推出新版本。
追求更高智能,Qwen 加速自我进化
大模型正走向自我迭代,本届云栖大会,阿里系统展示了千问大模型自我进化的最新探索成果。
在模型自我训练上,Qwen3.8-Max 通过自主搭建训练流程、构造训练数据,并自主设计实验、定位缺陷,在人类完全 「零参与」 的情况下持续迭代超 1 个月,完成 33 轮有效迭代。基于 RSI、后训练等系列技术联合优化,Qwen3.8-Max 新版本在 Artificial Analysis 上的得分从 40 涨至 45 分,与 Claude、GPT 最强模型同处第一阵营,领先于 GLM5.3、Kimi-K3 等所有国产模型。
在推理优化上,Qwen3.8-Max 在从未见过的平头哥新款 GPU 上,自主适配优化了下代架构的 Qwen3.8-Flash 新模型的推理框架,实现单实例推理吞吐量提升 96%。
在芯片模型协同设计上,Qwen3.8-Max 仅基于一份真实的总线模块规范,自主展开前端、验证、后端的全链路自迭代,在自主运行超 60 小时、调用 EDA 工具超万次后,完成了减少 42% 面积的物理实现优化。
Qwen LLM 项目负责人刘大一恒表示,Scaling 是迈向 ASI 的关键路径,Qwen4.5、Qwen5 参数规模计划迈向 5 到 10T
大会现场,阿里展示了大模型核心领域的系列技术创新。在架构优化方面,Qwen3.8-Flash 提前开源下一代千问大模型架构,通过注意力机制和模型内信息传递机制等核心技术创新,在实现前沿模型性能的同时,训练成本骤降近 90%;同时依托于极少的参数激活,将推理计算效率推至全新的帕累托前沿,成为行业性价比 「斩杀线」 模型。在模态扩充方面,全模态模型 Qwen3.8-Omni 正式亮相,将音视频等不同模态高效纳入统一理解框架中,为大模型开辟全新的思考分区。在参数扩展方面,参数越大依然能带来更强的性能,未来千问大模型总参数量将扩展至 5 万亿甚至 10 万亿的规模。这些技术创新将成为新一代千问大模型的基石,据介绍,Qwen4 模型正采用全新架构展开训练,Qwen4.5、Qwen5 均在稳步推进中。
在不断探索大模型性能前沿的同时,阿里还通过 「全模态」「全尺寸」 的大模型开源,与全球开发者和企业共享前沿的 AI 技术红利。在全球最大的 AI 开源社区 Hugging Face 中,Qwen3.8-27B 模型超越 DeepSeek-R1、Meta-Llama3.1 等史上热门模型,斩获该平台历史上最受欢迎 (Most Likes) 的开源大模型。公开数据显示,阿里已开源 460 余个 Qwen 大模型,Qwen 开源模型下载量突破 30 亿次,衍生模型数超 30 万个,稳居全球第一开源模型家族。
视听生成模型升级,全新视频生成模型拟 11 月发布
在最富创意的视觉生成领域,阿里正通过视觉生成模型的持续迭代升级,让 AI 创造出更好的作品,让用户享受到更好的体验。
图像生成模型 Qwen-Image-3.1 亮相,它面向电商、创意、设计等真实商用场景全新优化升级,将原本数小时的视觉设计压缩至秒级交付,水准堪比专业设计师,还支持图像精准编辑。
音乐生成模型 Happy Shrimp 1.1 版本发布,在音乐表现、人声质量、多语种演唱及指令理解四个专业维度进一步提升,支持百余种曲风与十余种主流语言,覆盖人声歌曲与纯音乐两大生成场景。
世界模型最新版本 HappyOyster 2.0 Preview 亮相,通过对模型架构、训练方法和数据体系的全面升级,显著提升了智能实时交互、记忆能力、实时响应、物理规律遵循等核心能力,让世界模型真正从实验室走向真实可用。
阿里巴巴 ATH 技术副总裁,淘天集团首席科学家郑波在云栖大会现场提到, 三年内会出现一个原生全模态统一模型,体验将不再受限于模态的边界
全新的下一代视频生成模型也将于 11 月发布,朝着更长、更可控、更完整、更智能的方向演进:在更长的时间里,新模型仍然能保持一致性,创作者可精准掌控人物、场景与镜头;同时,模型能具备导演级的创作思维,从生成单个镜头迈向理解完整叙事。
下代语音模型发布,Qwen 落地多款智能终端
当前,语音正发展成为 AI 与人之间更自然的交互入口,Qwen 模型也在手机、AI 眼镜、桌面机器人等硬件领域落地。
语音模型家族 Qwen-Audio-3.1 全新升级,包含语音转写 (ASR)、语音合成 (TTS) 和实时语音交互 (Realtime) 三大系列。
基于下代架构的音频理解模型 Qwen-Audio-3.1-ASR-Next 全新发布,它能够理解人物情绪、音乐、环境声与机械声,完成声音描述、事件定位、音频问答与推理,让 「这段录音中人的情绪怎样」 这样的问题能够被理解和准确回答。
同时,音频创作模型 Qwen-Audio-3.1-TTS-Next 全新亮相,它采用全新架构,可根据一段脚本,直接生成融合对白和环境声的完整音频,极大提高有声书、影视剧和播客等专业创作的效率。
Qwen-Audio-3.1-Realtime 实时交互能力再提升,能够边听、边想、边说,并进一步增强多语言交互、角色扮演和共情能力。目前,该系列模型已应用于千问办公和 Qoder,并接入 QwenNote A2 随身助理、QwenNote Eva 桌面机器人和千问 AI 眼镜等硬件产品。
此外,同声传译模型 Qwen3.8-LiveTranslate 首次登场,人类同传平均时延在 4 秒以上,但该模型可将时延压缩至不到 2.5 秒。据了解,新模型已接入千问 AI 眼镜、QwenNote A2、钉钉耳机等 AI 硬件。
阿里大模型加速走向终端。AI 手机全栈解决方案 Qwen Intelligence 发布,专为手机场景深度优化,为合作伙伴提供基于千问大模型的 Agent 技术平台,让手机能够更可靠地完成跨应用的复杂任务。
阿里巴巴 AI 大模型全景图