文 | 字母 AI
GPT Image 2.5 凌晨突发,把改图能力端了出来。
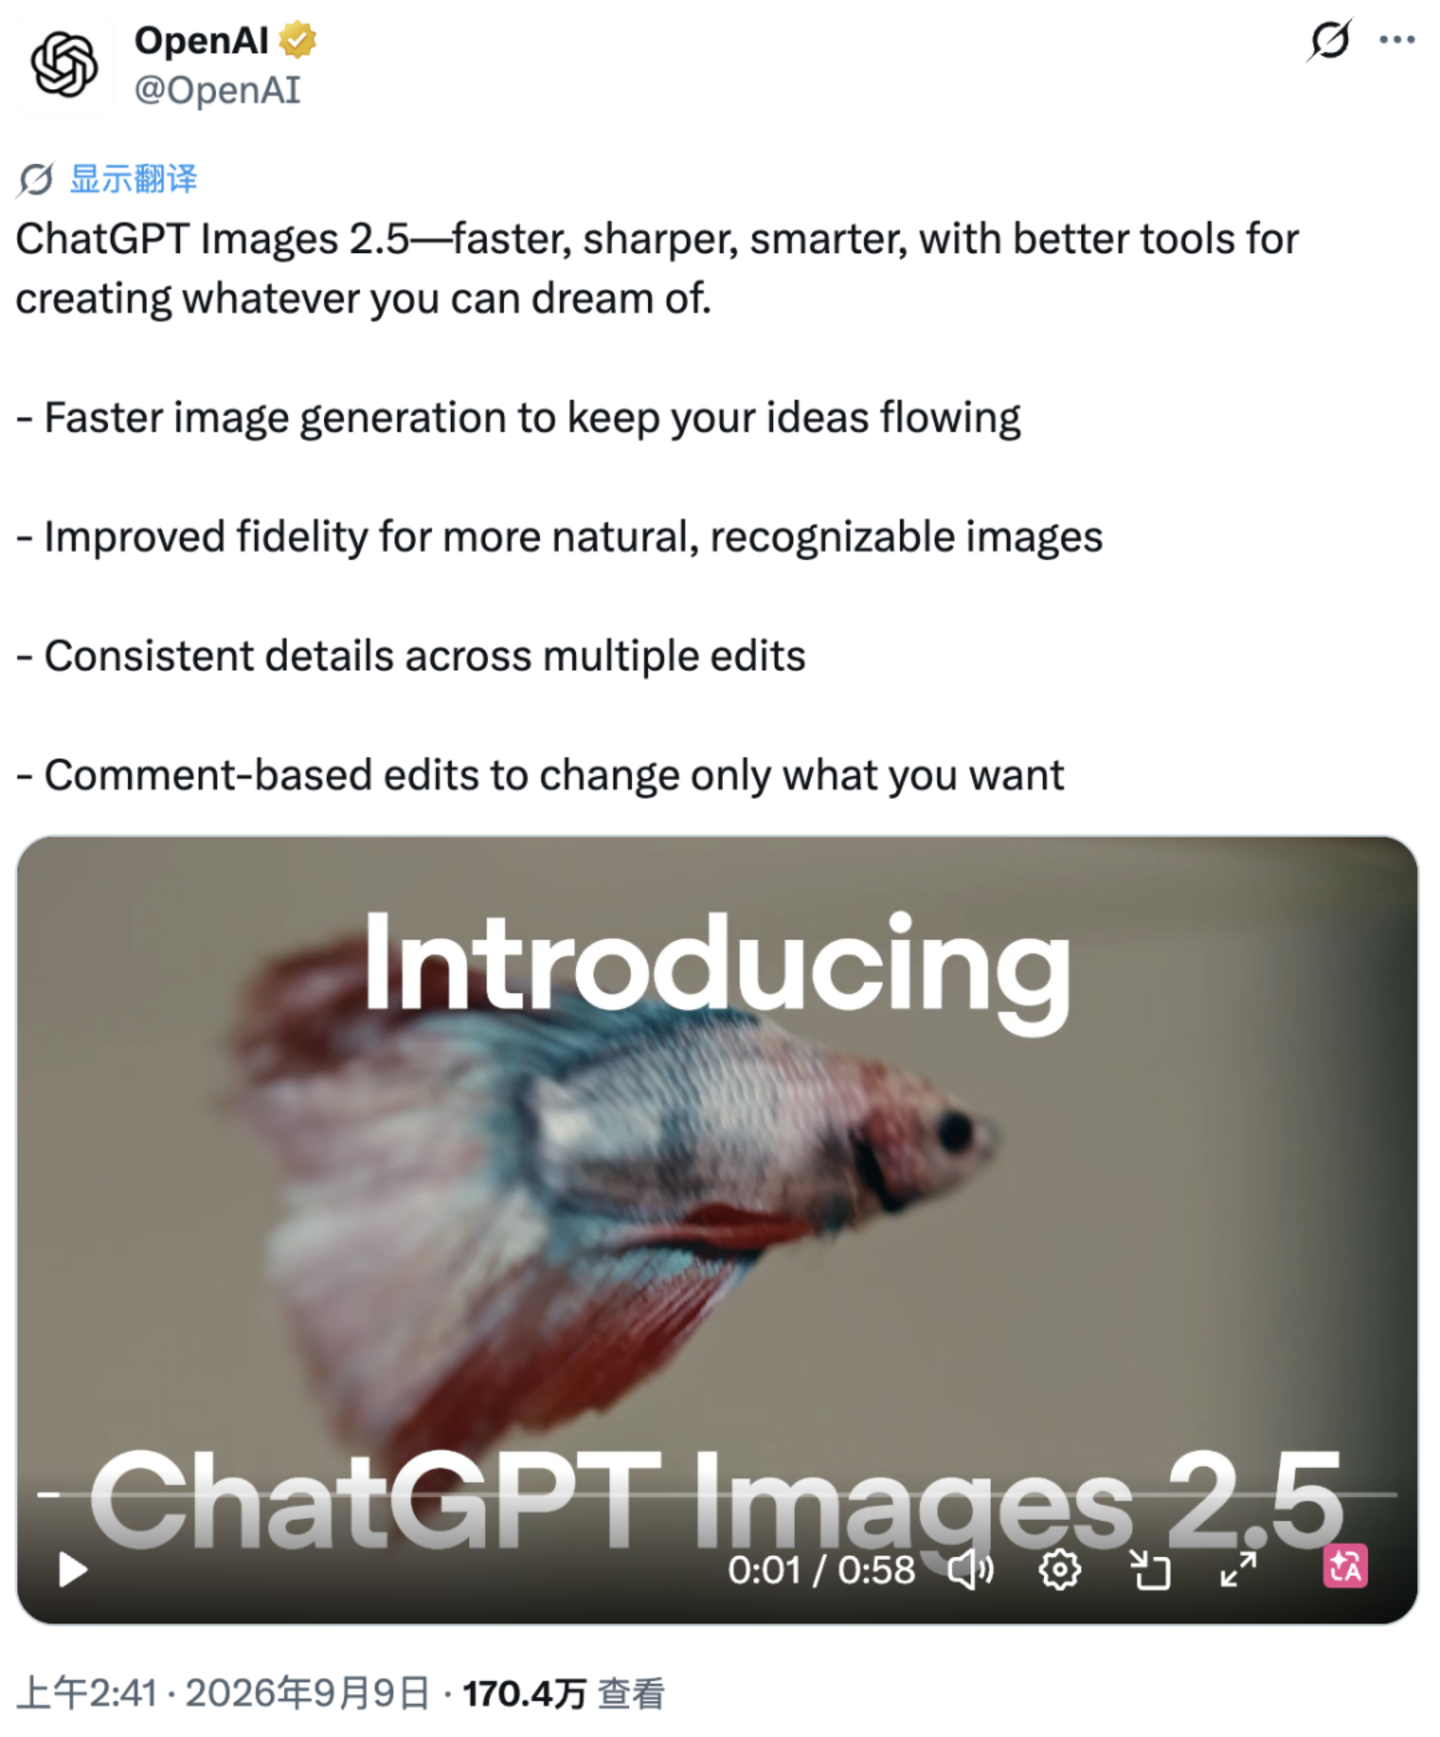
局部编辑、连续编辑、多轮一致性乃至图片上直接标注修改,OpenAI 这次把 「无需抽卡,拥抱多轮修改」 当成了主菜。
但问题是,这菜多少有点没新意——同样的东西,NanoBanana 一年前就已经玩过了。
NanoBanana 一代就已经把连续编辑做成了核心能力;第一代发布四个月后,谷歌连可视化圈选编辑的产品交互都做了;到大香蕉 (Pro) 那里,谷歌已经把这条路往前走到了相机、灯光、构图和多主体控制;二代香蕉又把 Pro 的核心能力压到了 Flash 的速度。
OpenAI 也算是补了 NanoBanana 的课,但显然还没毕业。
修改效果更好
抛开 「新不新」 这个问题,GPT Image 2.5 这次的升级幅度其实不算小。
OpenAI 自己把重点写得很明确:更精确的编辑、更稳定的多轮一致性,以及更快的生成速度。
相比 Images 2.0,新模型最高可以降低 50% 的生成延迟,同时改善参考图主体保真度、自然光照和纹理表现。
但在官方文档里被 OpenAI 反复强调的,还是 「编辑」。
首先是 Precision Editing(精确编辑)。
之前的 Image 2.0 虽然也能改,但往往改得不够精准,只想动一个局部,整张图却可能跟着大变样,图片主体的位置甚至都会发生偏移。
GPT Image 2.5 试图把这种 「牵一发而动全身」 压下去,OpenAI 称,新模型可以只修改用户指定的元素,同时尽可能保持主体、构图、背景乃至品牌视觉不变。即使面对更复杂的主体和背景,也可以单独替换商品、文案或者局部元素。

更重要的是 Multi-turn Editing Consistency(多轮编辑一致性)。
简单来说,就是一张图改完第一轮之后,可以直接接着改第二轮、第三轮;此前已经做好的修改尽量保留下来,新一轮修改继续建立在上一轮结果之上,而不是每次重新理解、重新生成。
OpenAI 专门强调了一个过去很麻烦的问题:图片质量不应该随着编辑轮数增加而一路劣化。
体现在 gif 图里,就是图不停改,但不再乱动,看起来更稳定。

GPT Image 2.5 这次把 API 分成两个版本:偏速度的 Flare(闪光) 和偏最高质量的 Sunburst(翻译过来是 「从云隙射下的阳光」,只看名字的话,应该有更强的光影效果和更高的审美);要我说,OpenAI 最近和有什么起名癖似的,尽整些花里胡哨的。
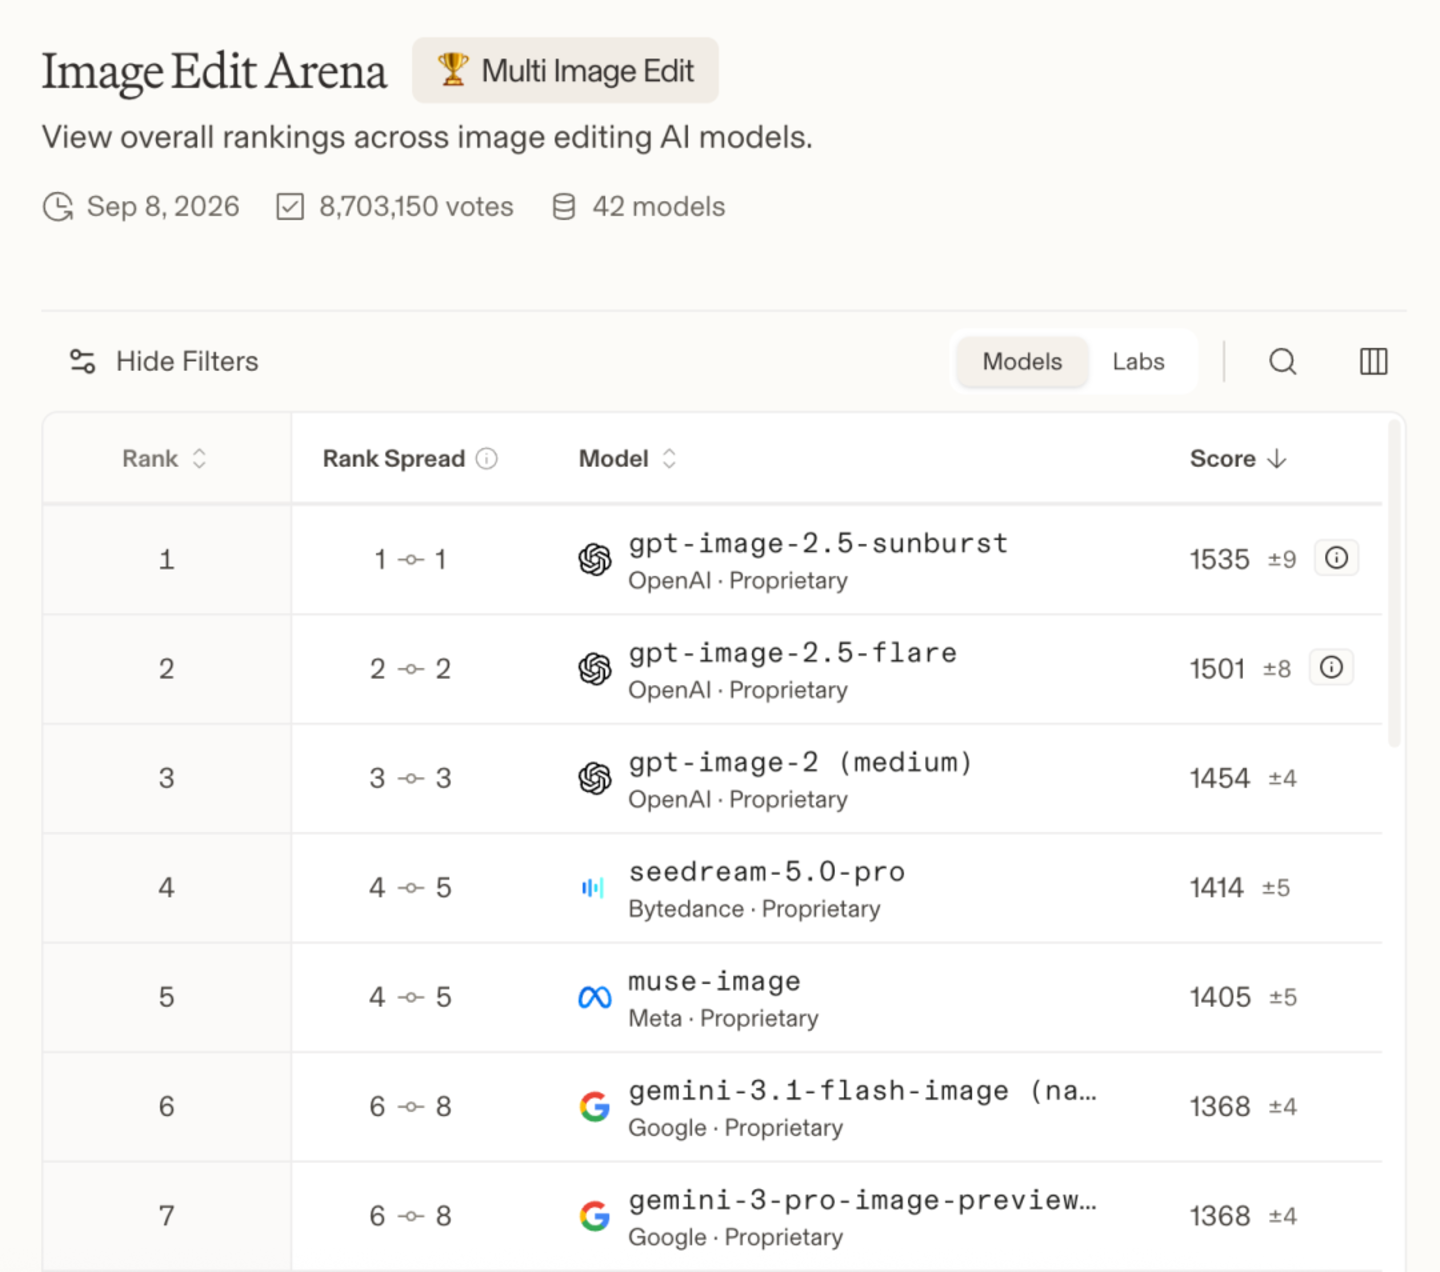
在 Arena 最新公布的结果里,Sunburst 和 Flare 直接包揽了文生图、单图编辑和多图编辑三个竞技场的第一、第二名。加上 Image 2,前三已被 GPT Image 包圆。
不过需要区分的是,Arena 这里测的是 「多图输入编辑」,并不是 OpenAI 官方强调的 「多轮图像编辑」。
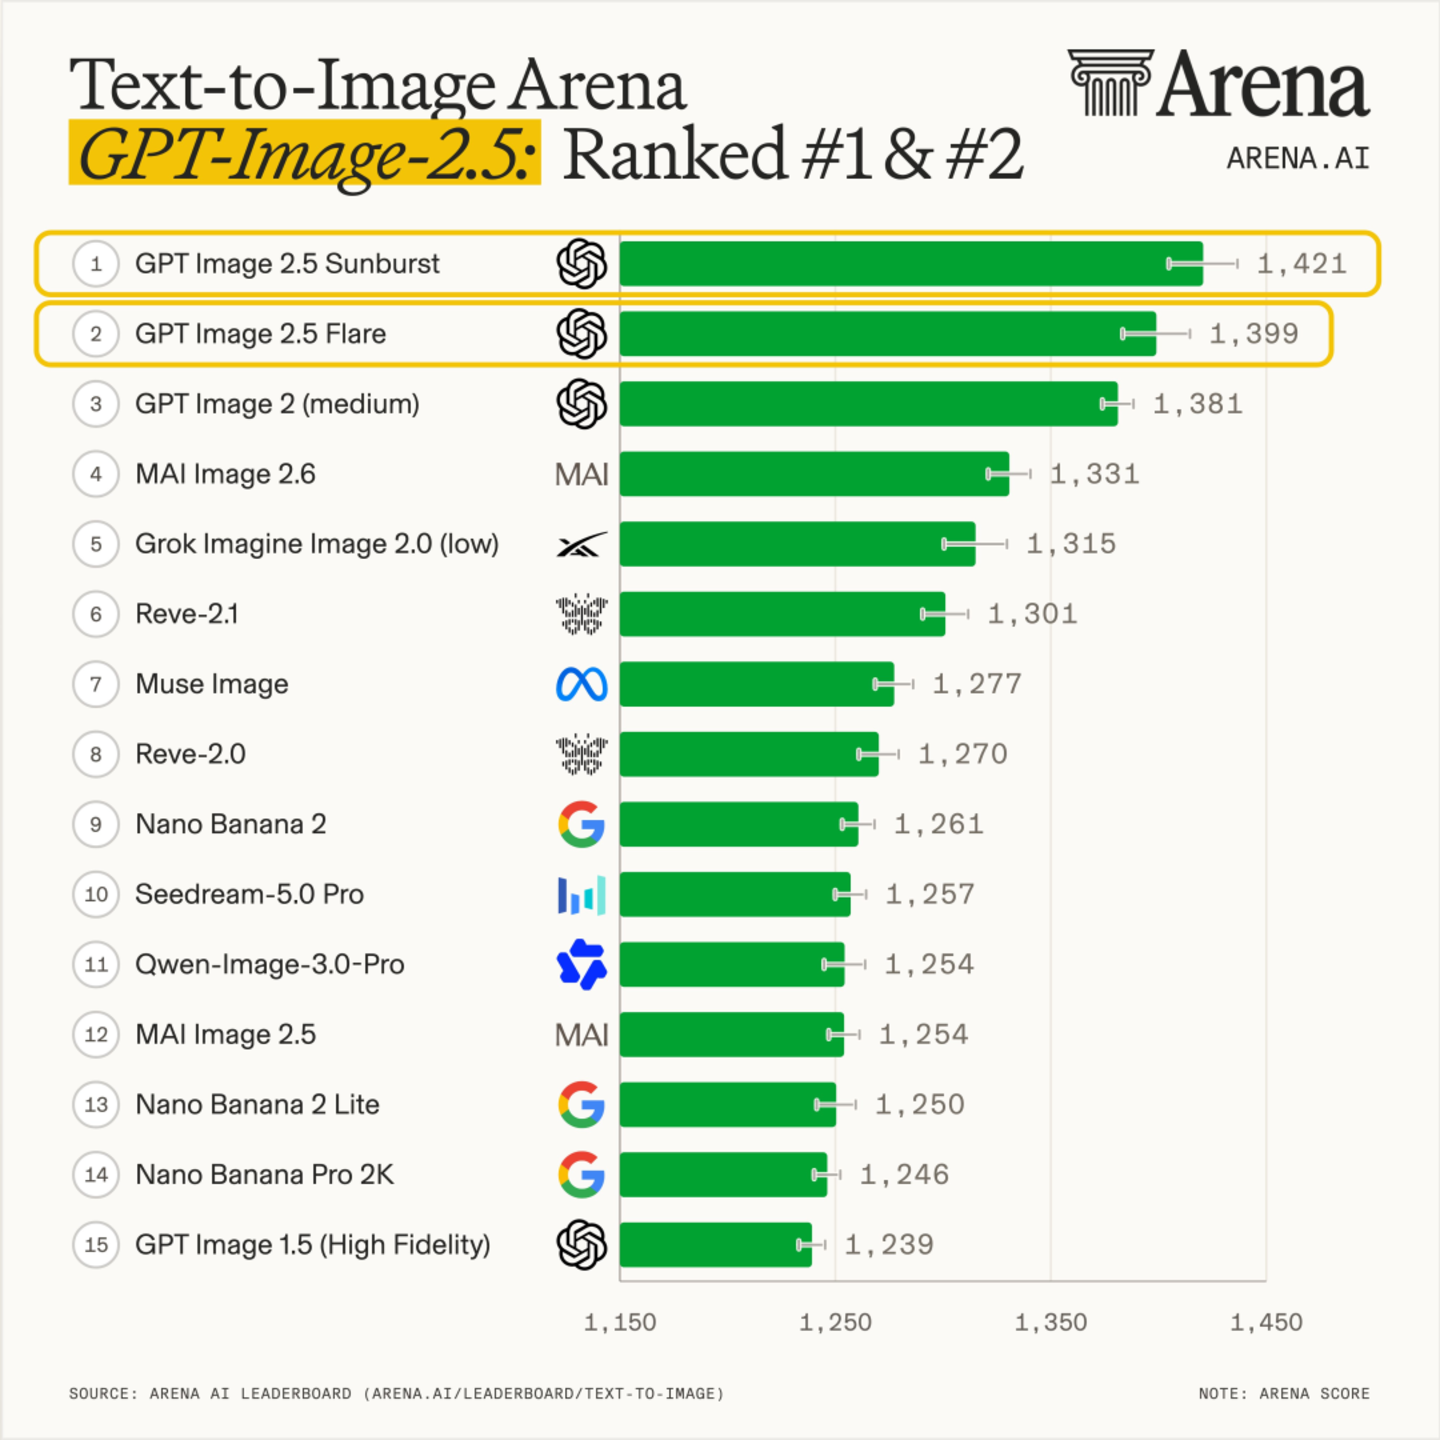
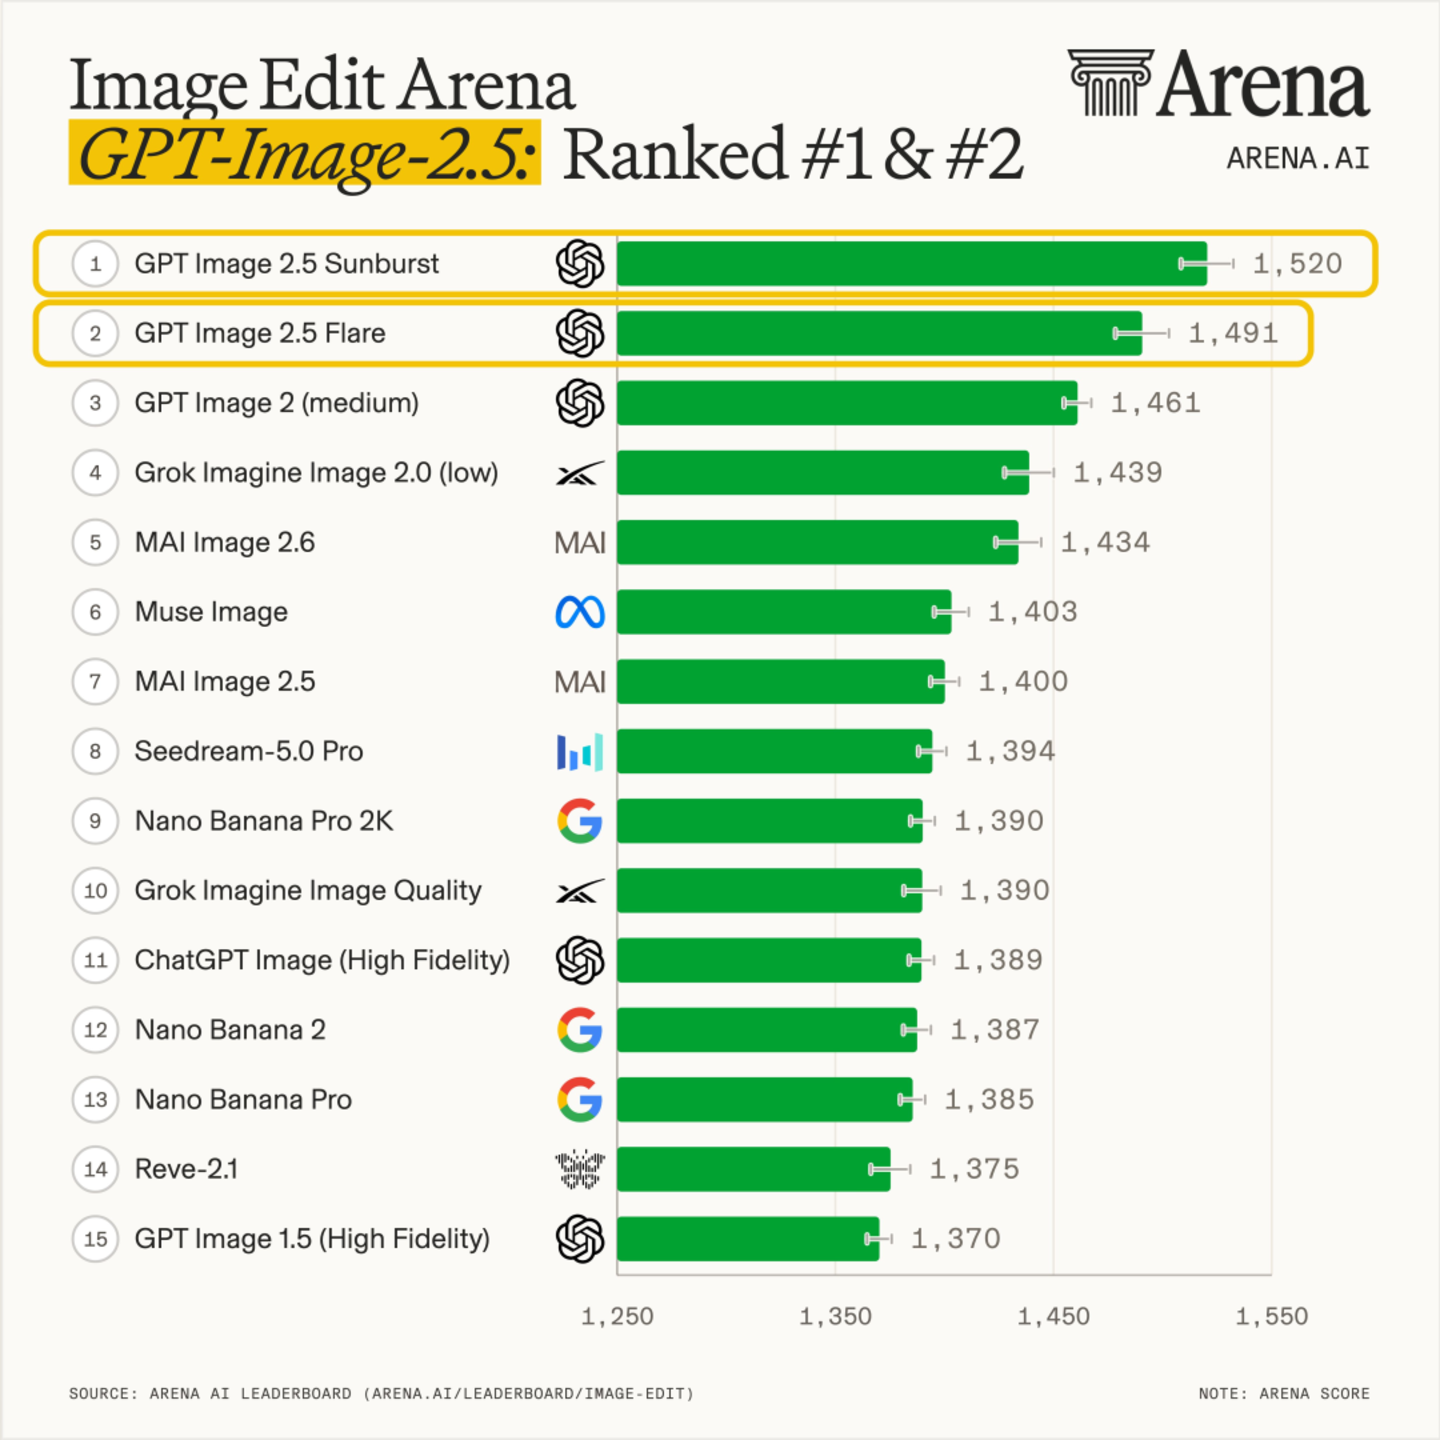
更值得注意的是它们相对 GPT Image 2 的提升幅度。
Sunburst 在文生图上提高了 40 分,单图编辑提高 59 分,多图编辑则直接提高了 81 分;Flare 分别提高 18、30 和 47 分。
至少在大模型盲测竞技场上,Image 2.5 这次最明显的提升,集中在对已有图片的编辑能力上,尤其是同时处理多张参考图的复杂编辑任务。
在 API 侧,Flare 被 OpenAI 定义为默认模型,相比 GPT Image 2 在获得更高质量的同时,延迟降低 50%;Sunburst 则牺牲一些速度,换取更精细的控制,主要面向广告素材、商品图等场景。
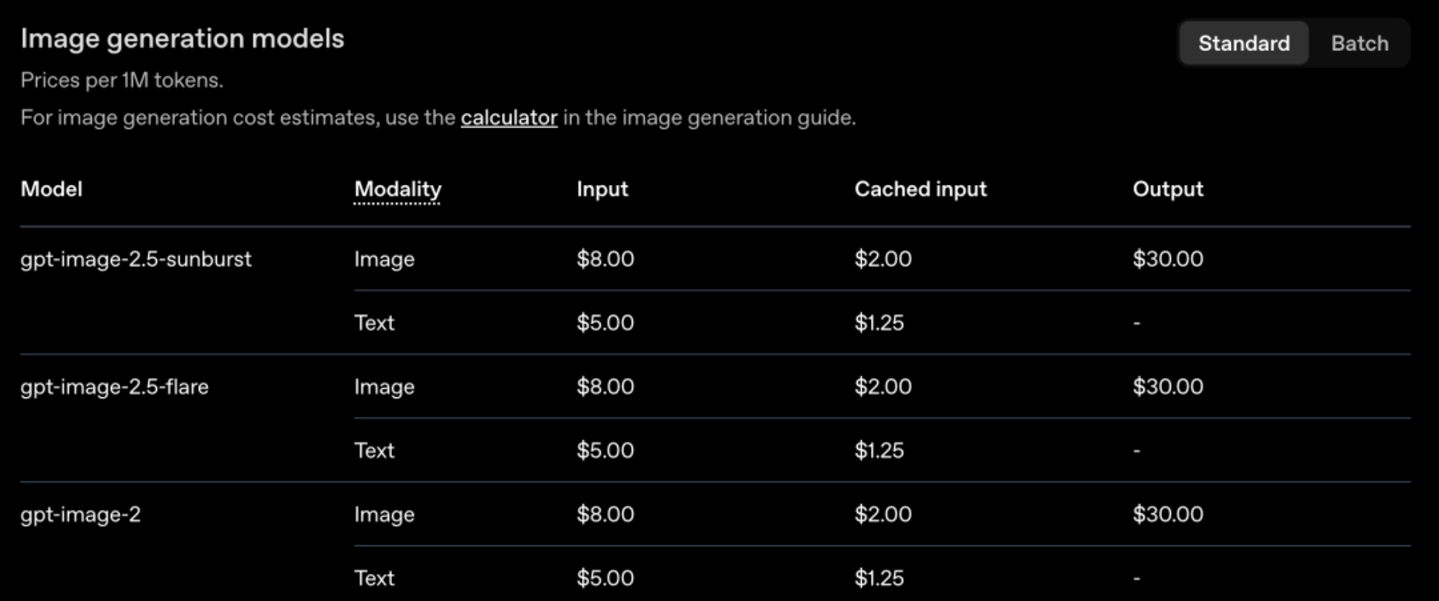
定价方面,OpenAI 最新价格页显示,GPT Image 2.5 Flare 和 Sunburst 的图像输入都是 8 美元/百万 token、图像输出 30 美元/百万 token、文本输入 5 美元/百万 token,和 GPT Image 2 一毛一样。
有意思的是,Flare 和 Sunburst 一个主打速度,一个主打质量,但 API 账单暂时看不出区别,合理怀疑 OpenAI 又出 bug 了。
还有什么变化
相比 Midjourney 更容易让人想到 「把一张图片做得更有风格」,OpenAI 更喜欢把文字、图片、布局和信息揉在一起,直接生成一个视觉成品。
比如海报、商品素材、信息图、人物照片、品牌视觉,以及各种带有大量文字和排版的设计——Image 2.5 在这方面和 Image 2 一脉相承。
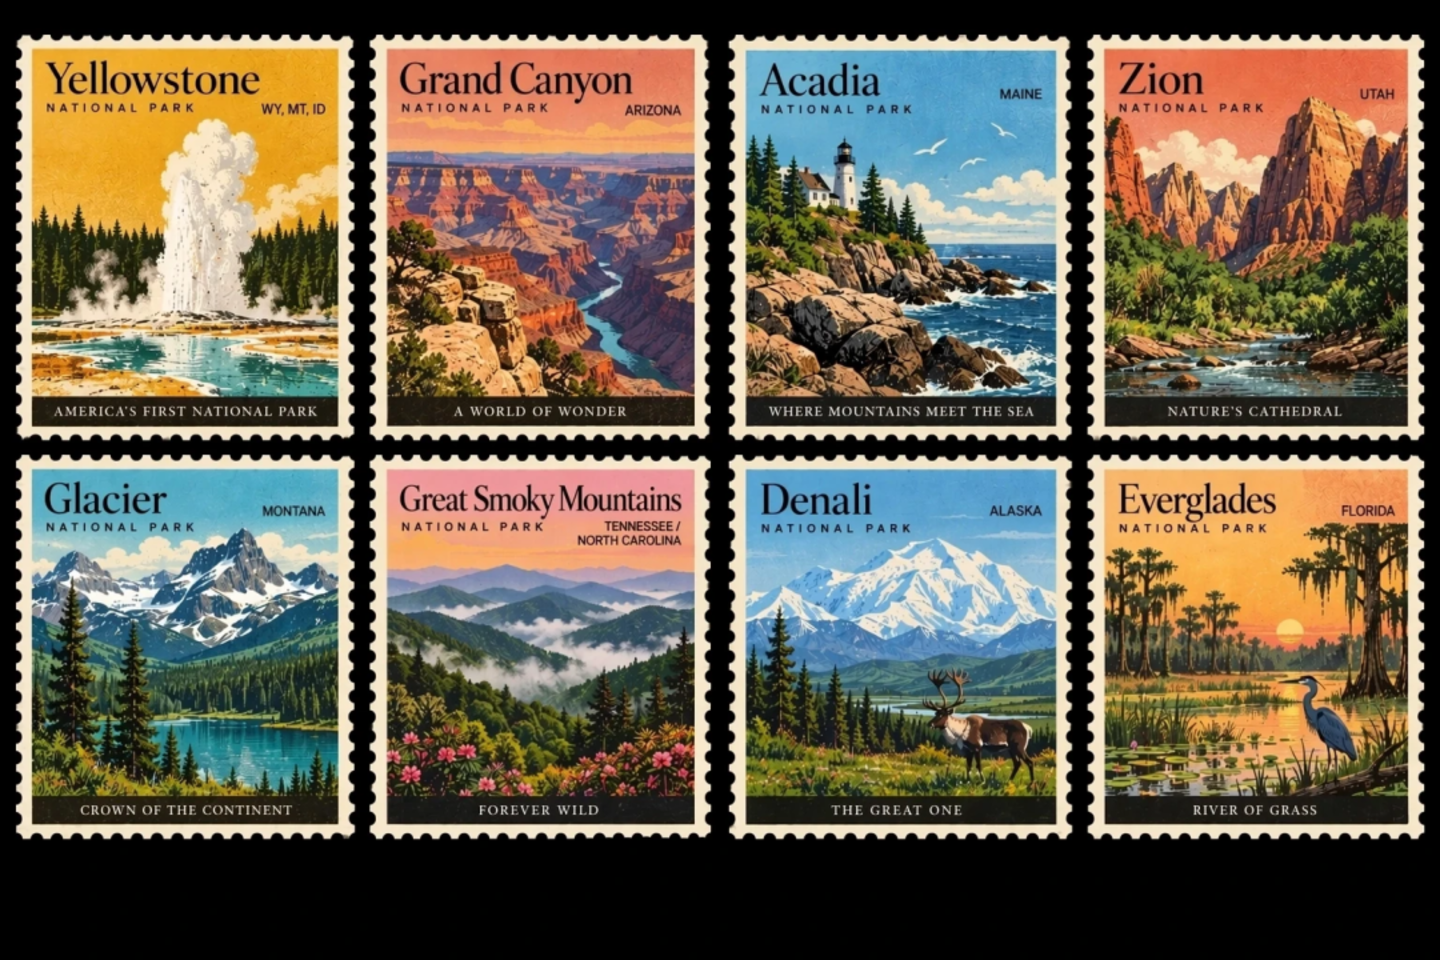
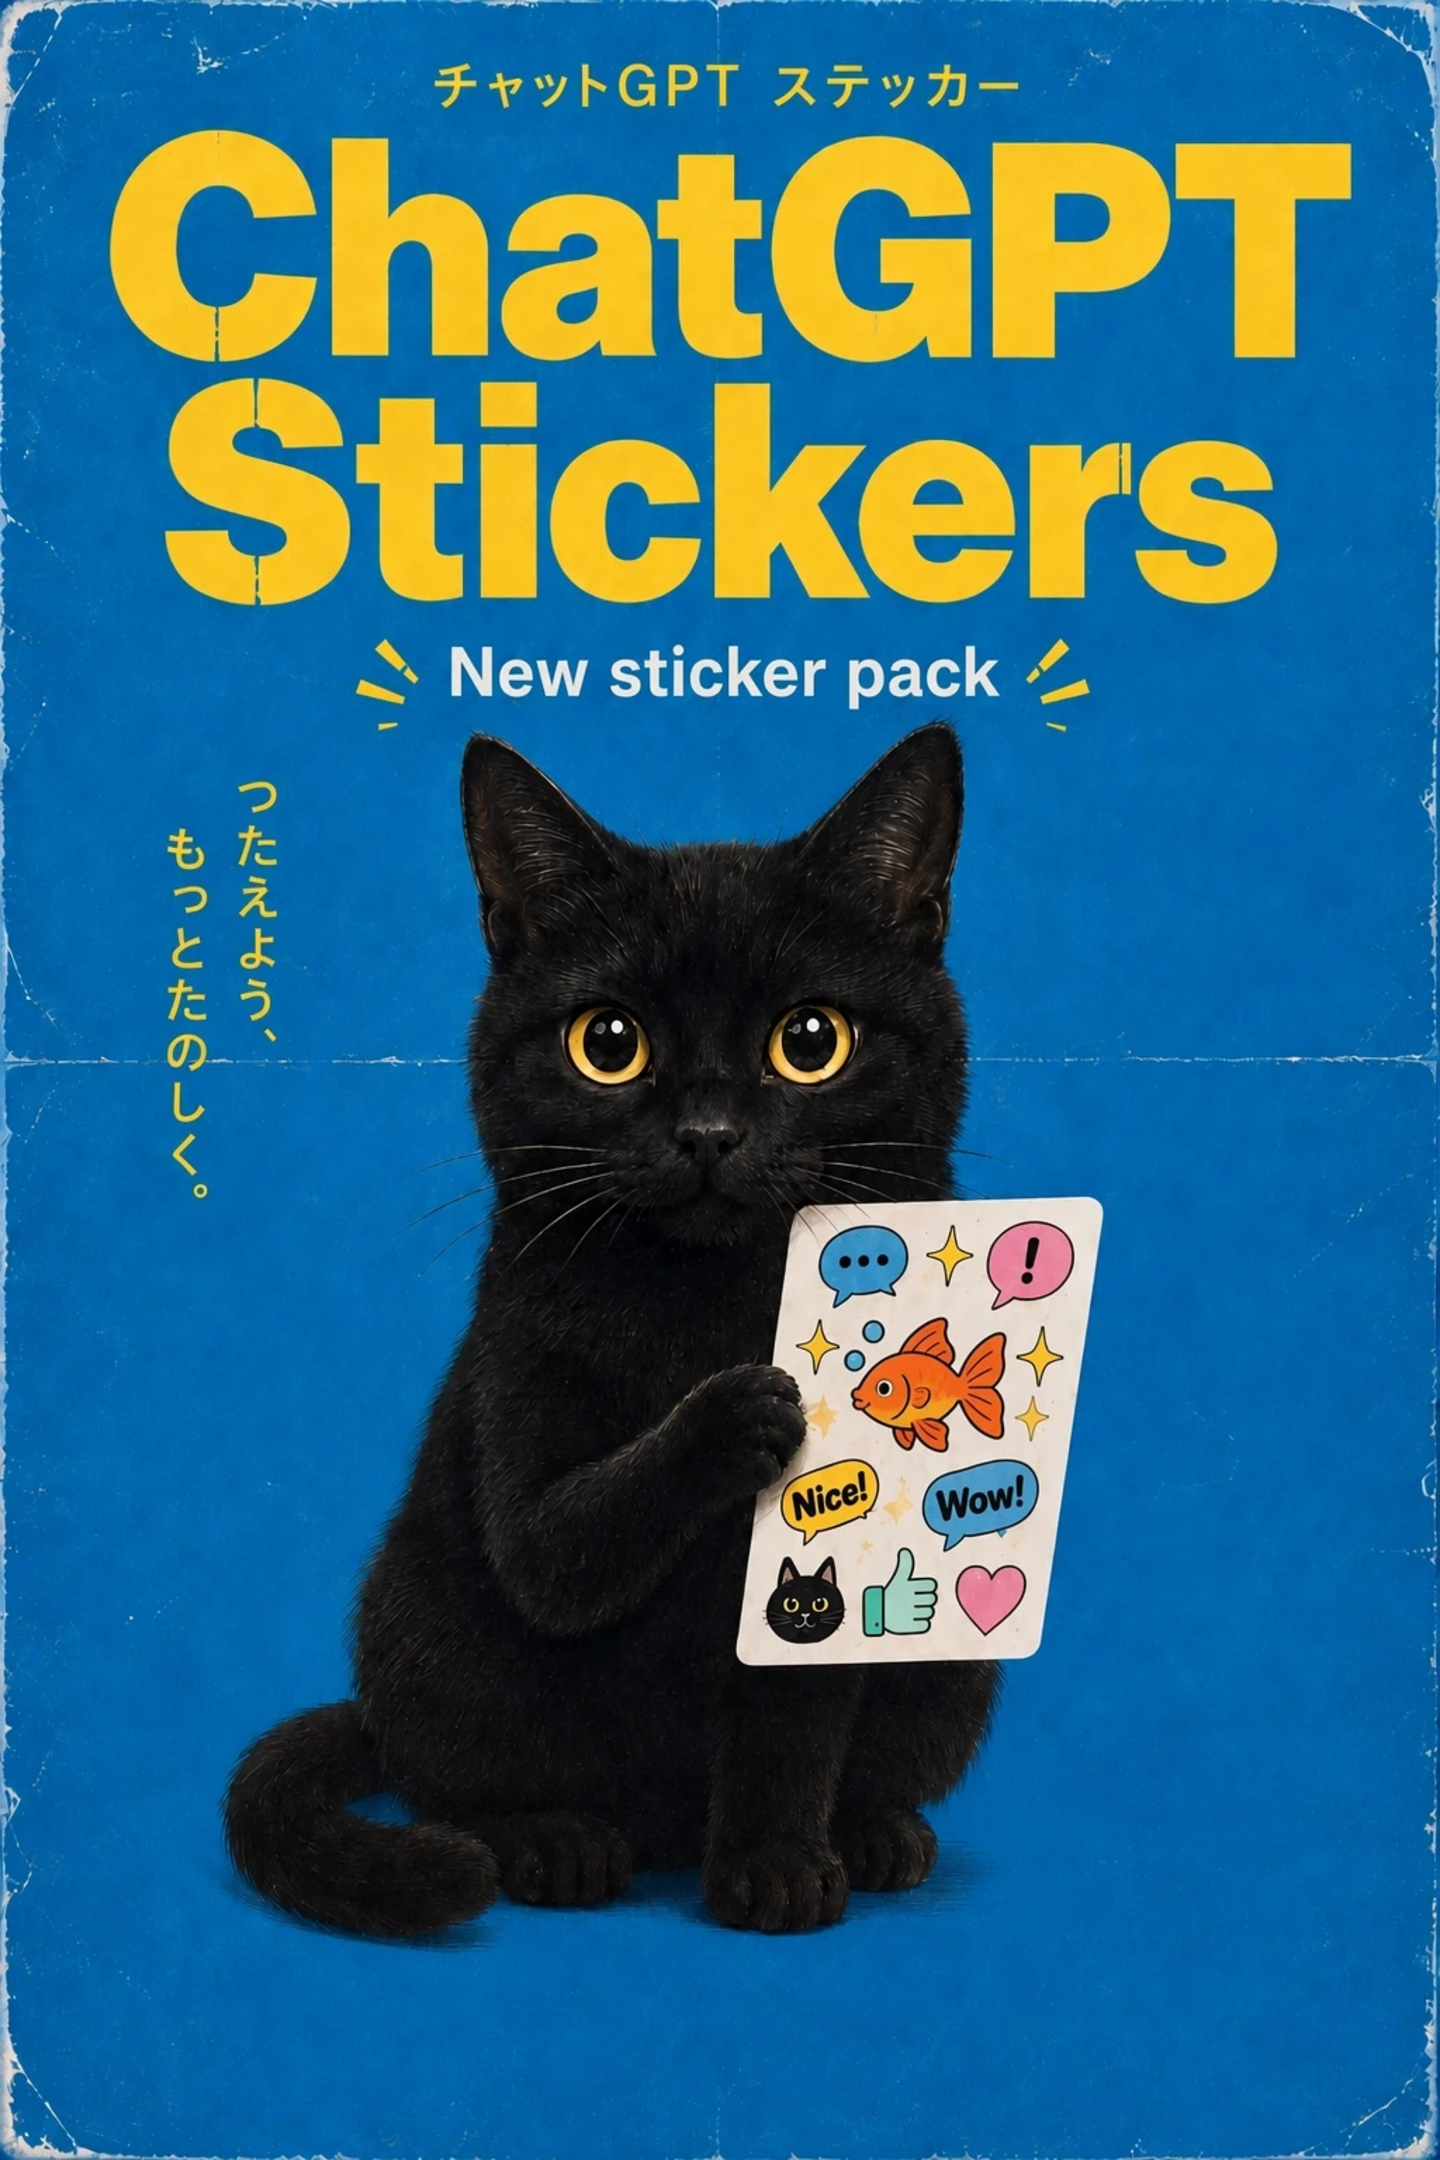
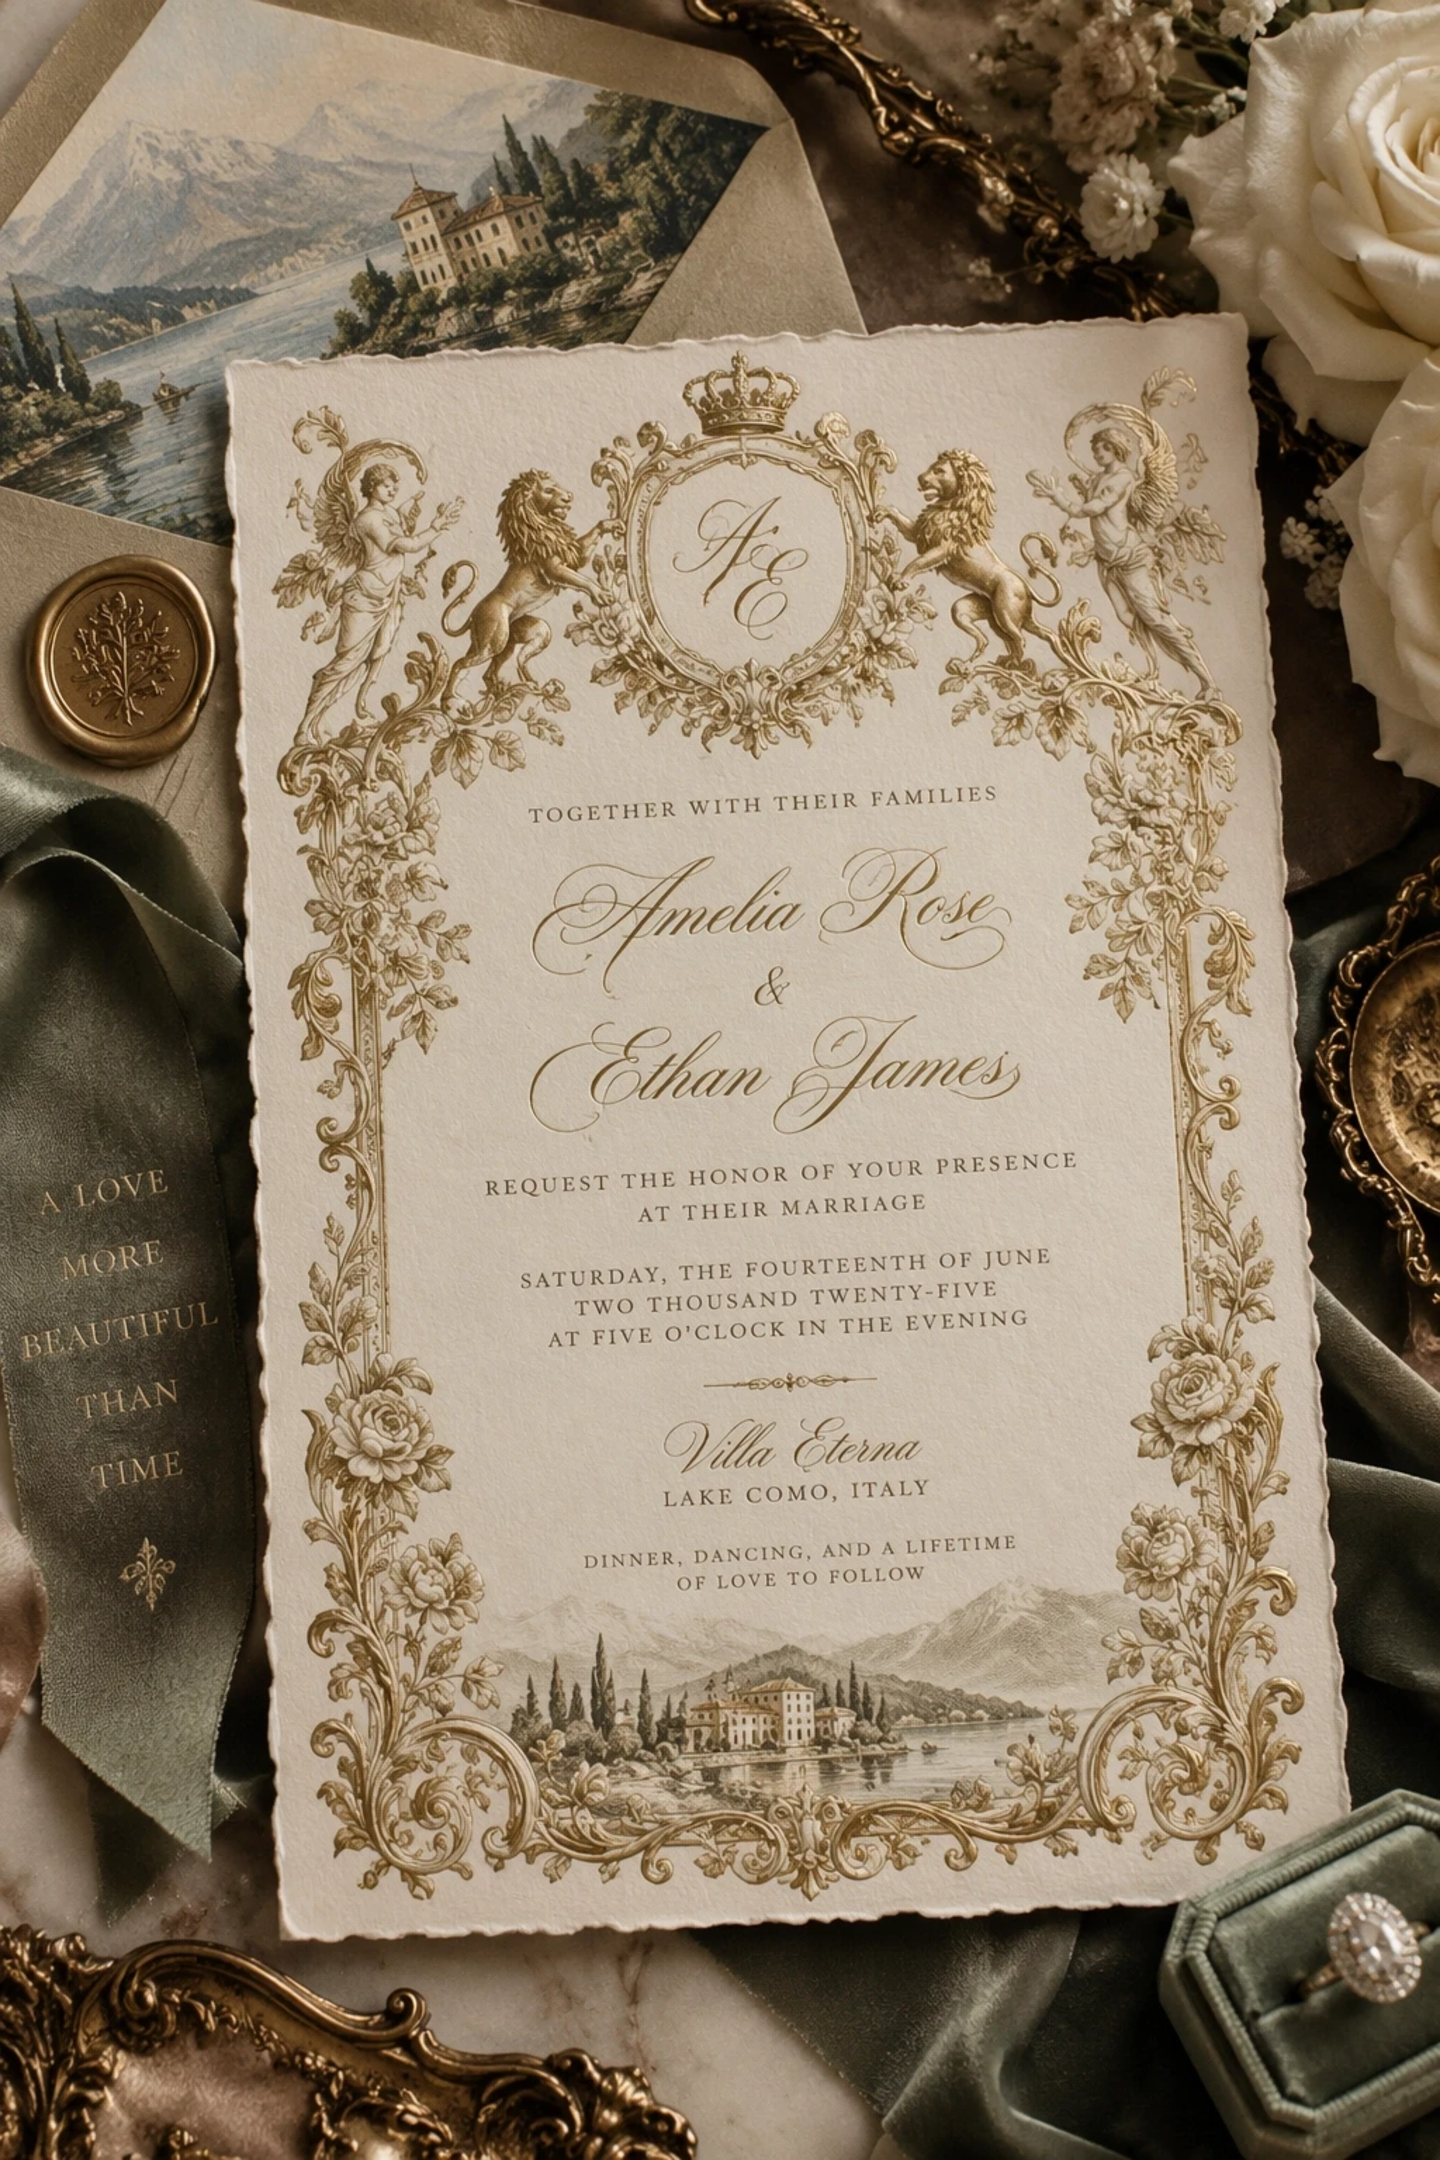
但和 Image 2 更强调 「一次生成就能直接拿来用」 不同,Image 2.5 这次把大量展示空间留给了改图,即一张已经生成好的图,还能不能继续往下改。
OpenAI 称,新模型把人物放进新的场景、风格和构图之后,更容易保留原有主体的辨识度,光线和纹理也会更自然。
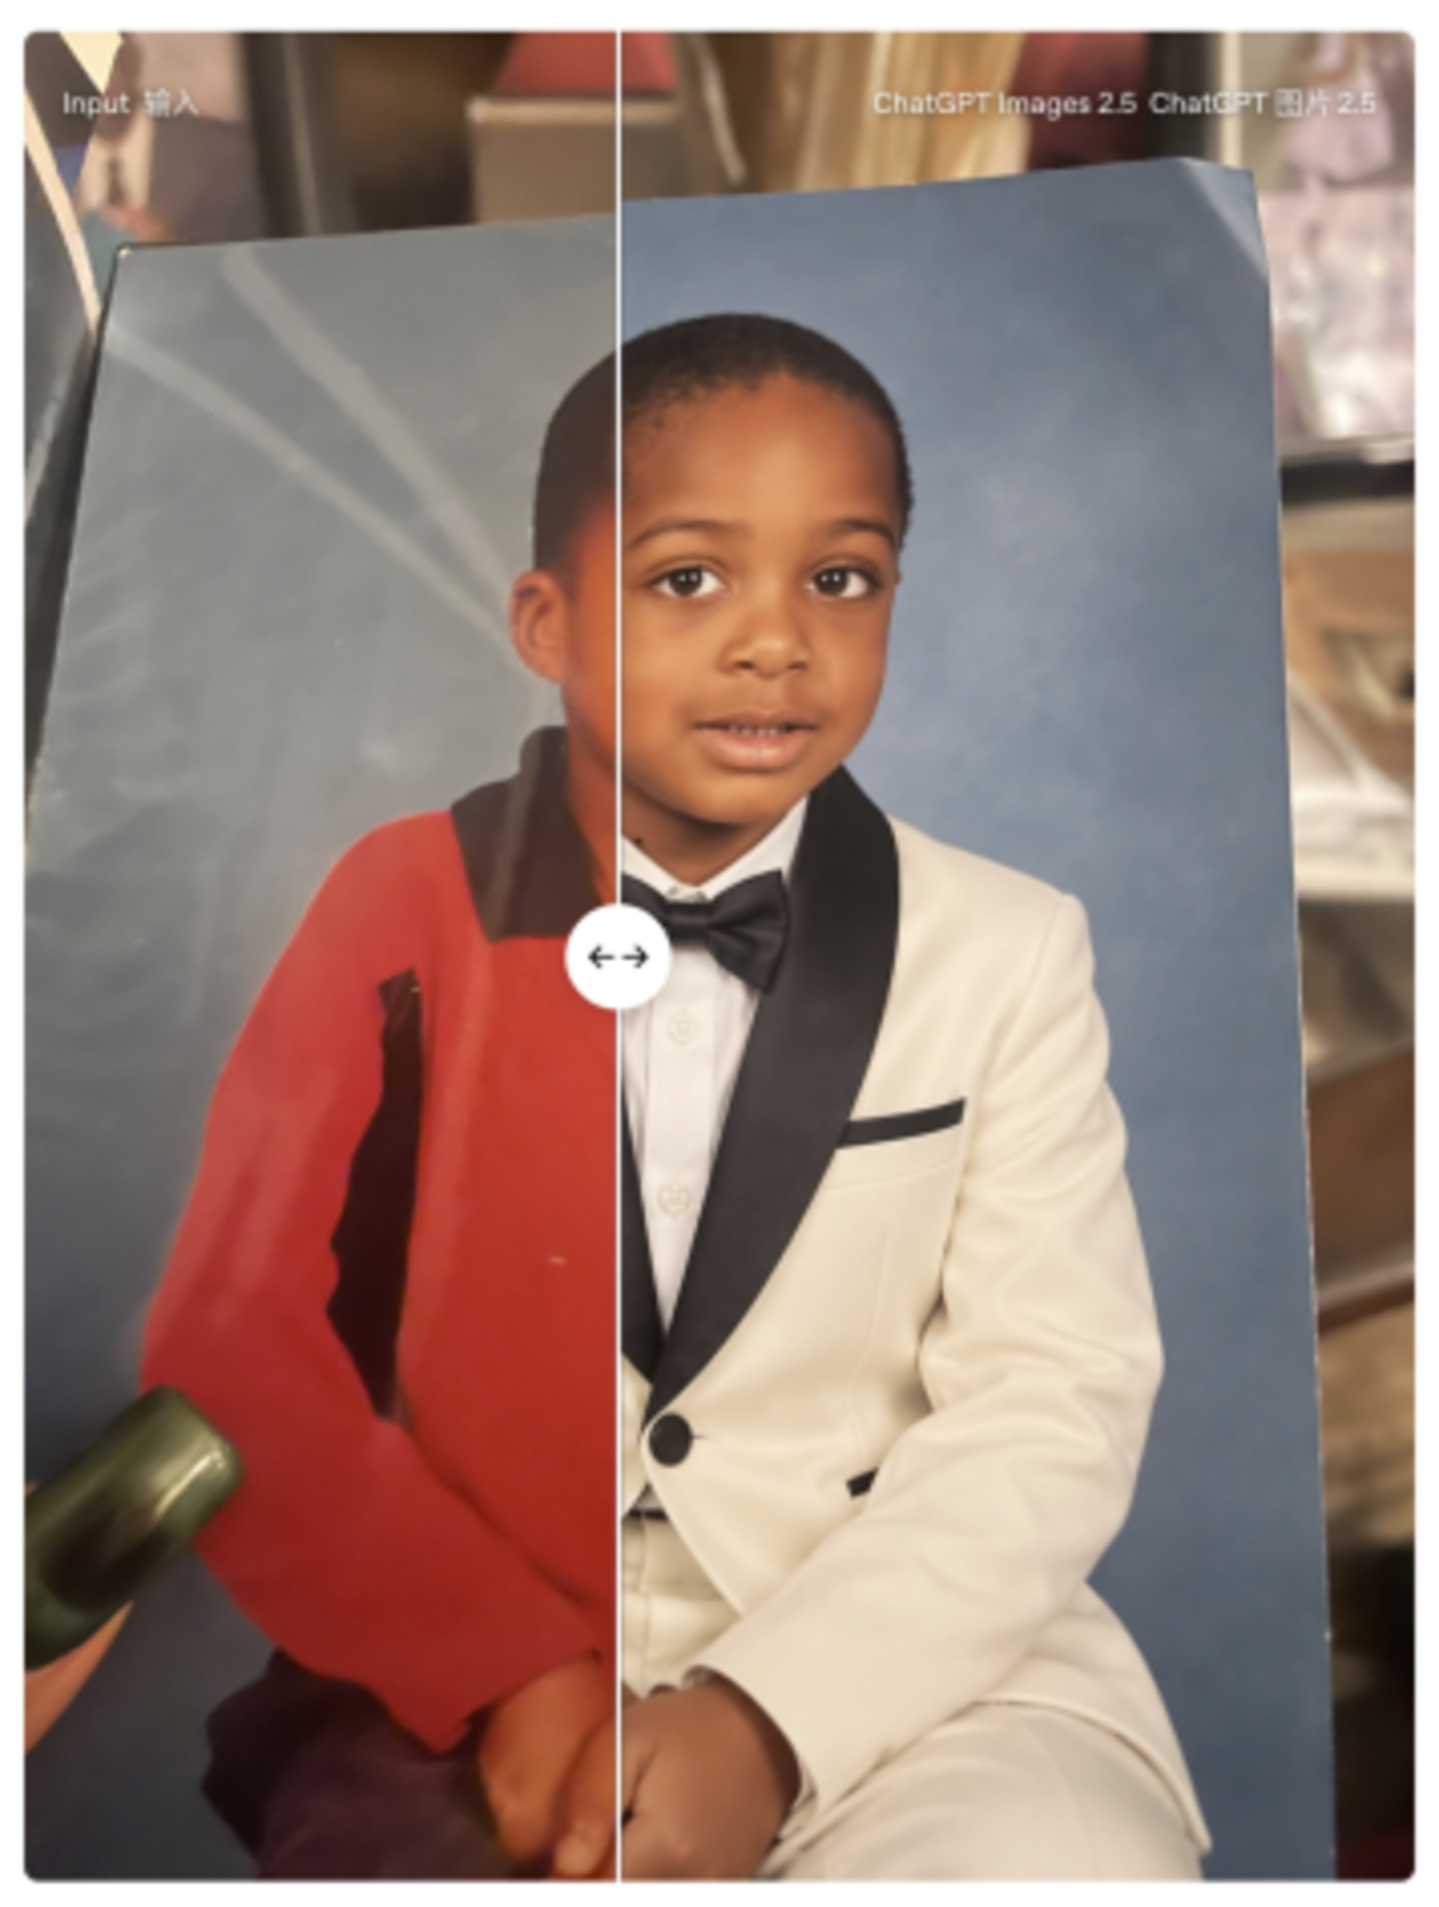
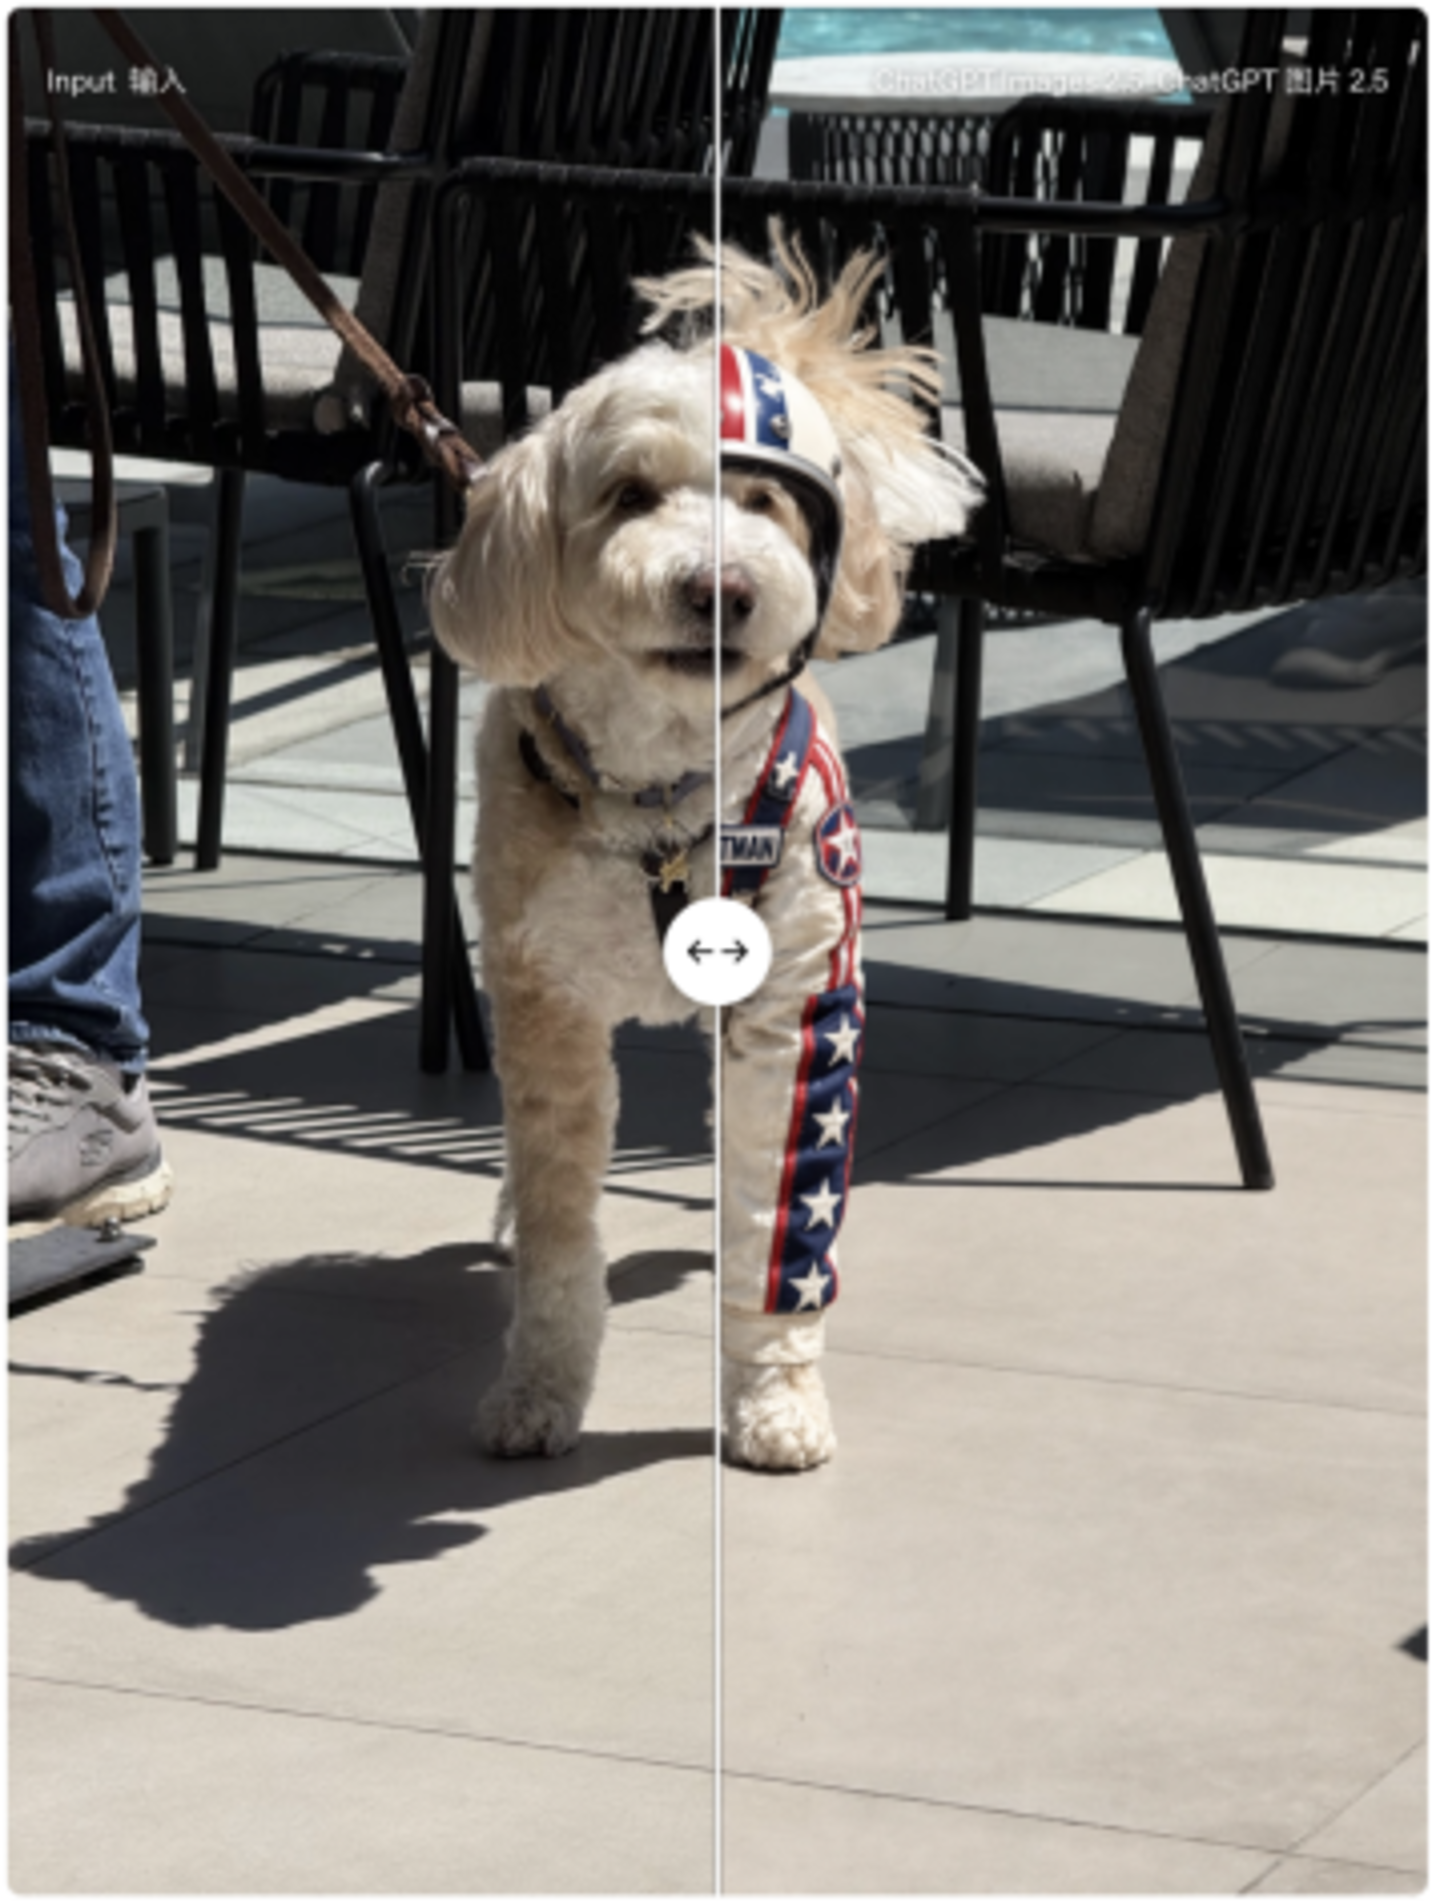
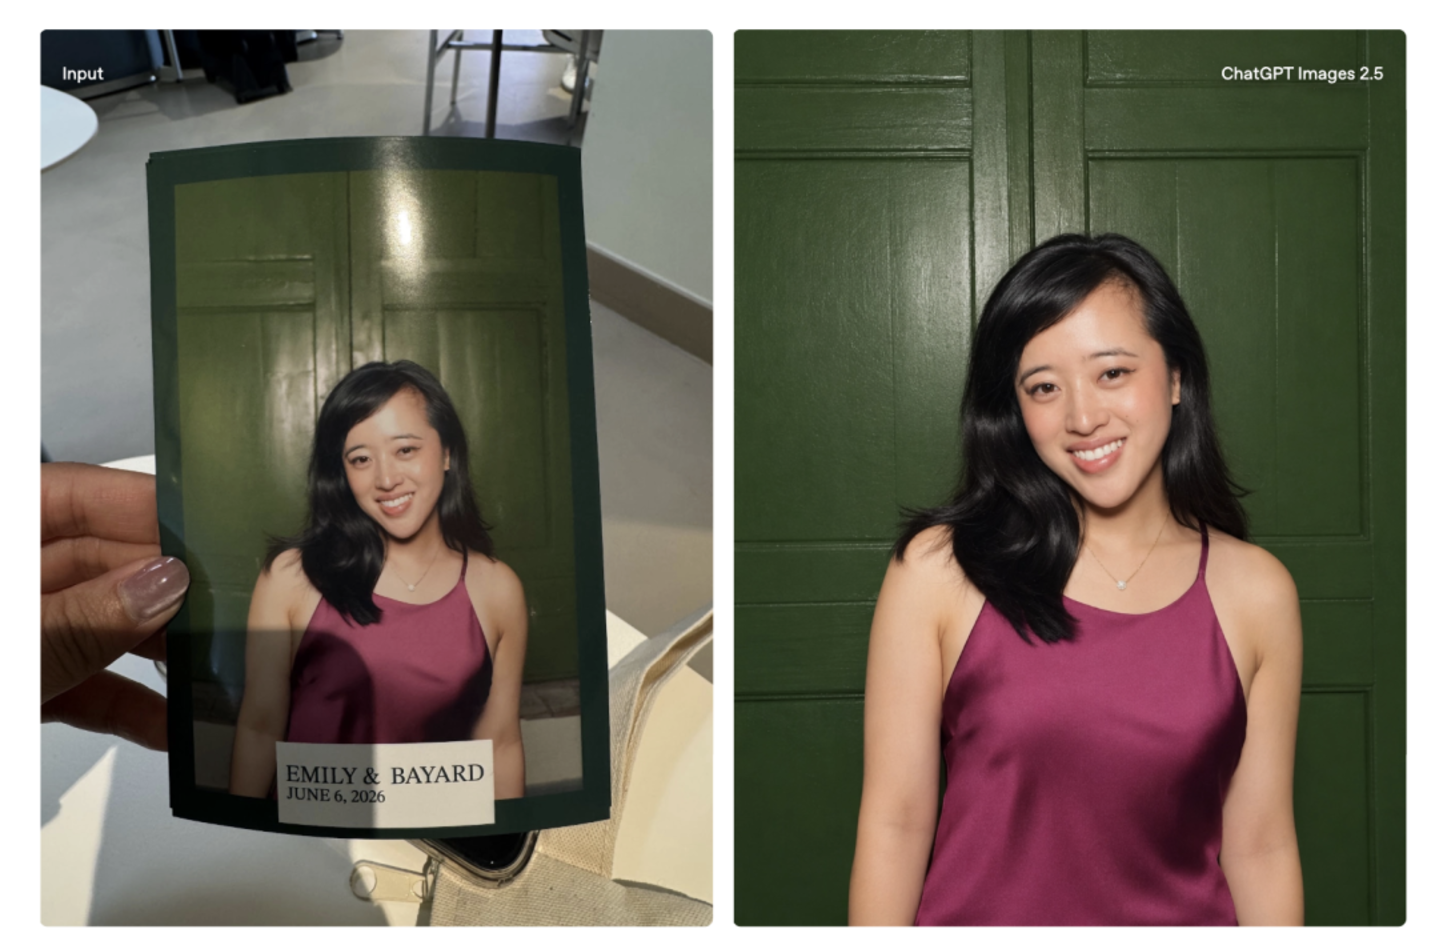
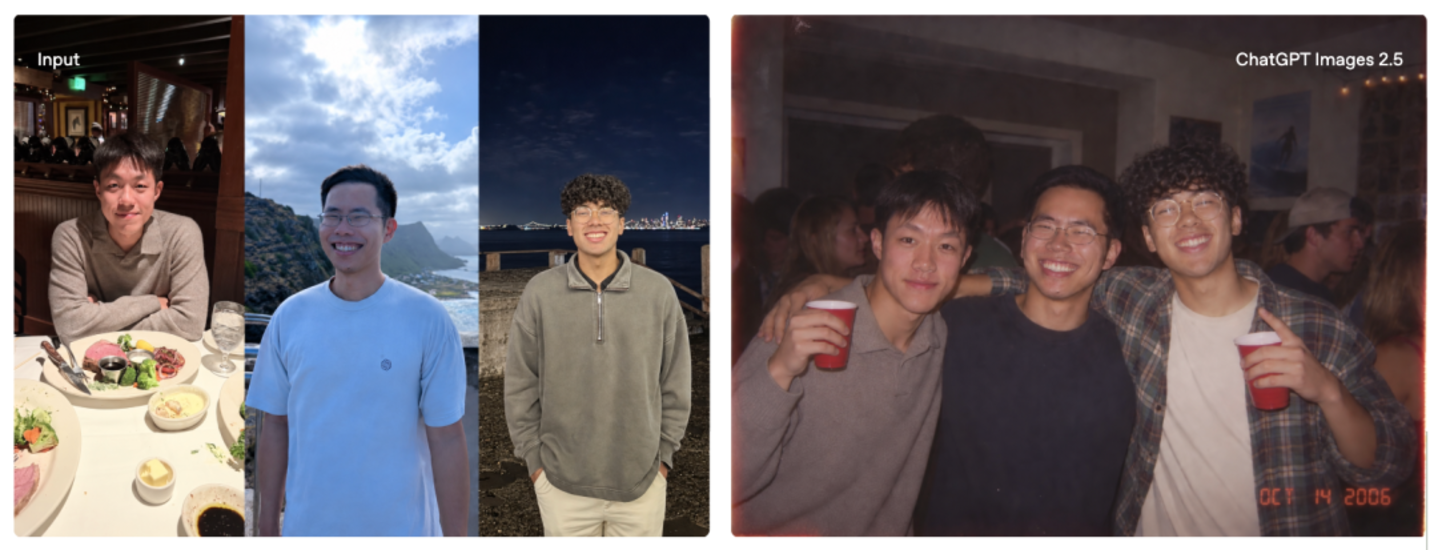
除了模型本身,OpenAI 这次还补充了两个 「新功能」。
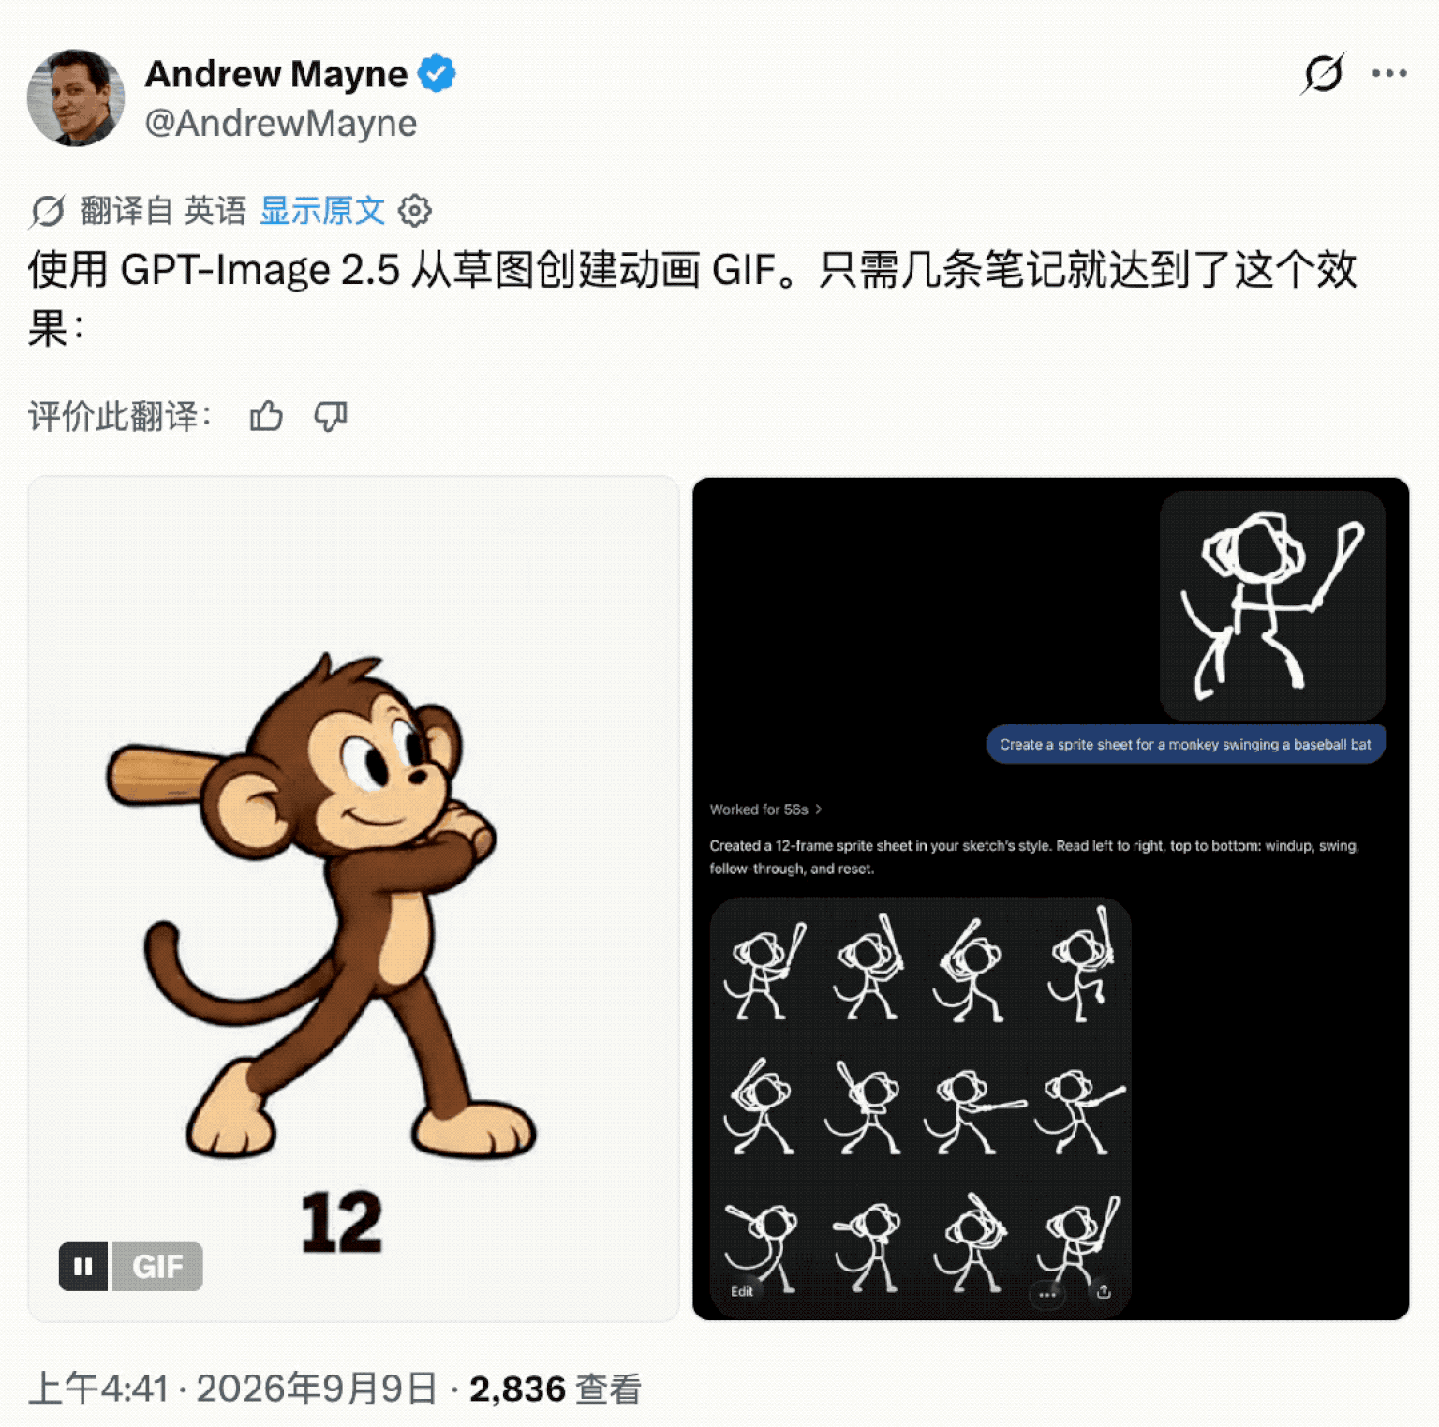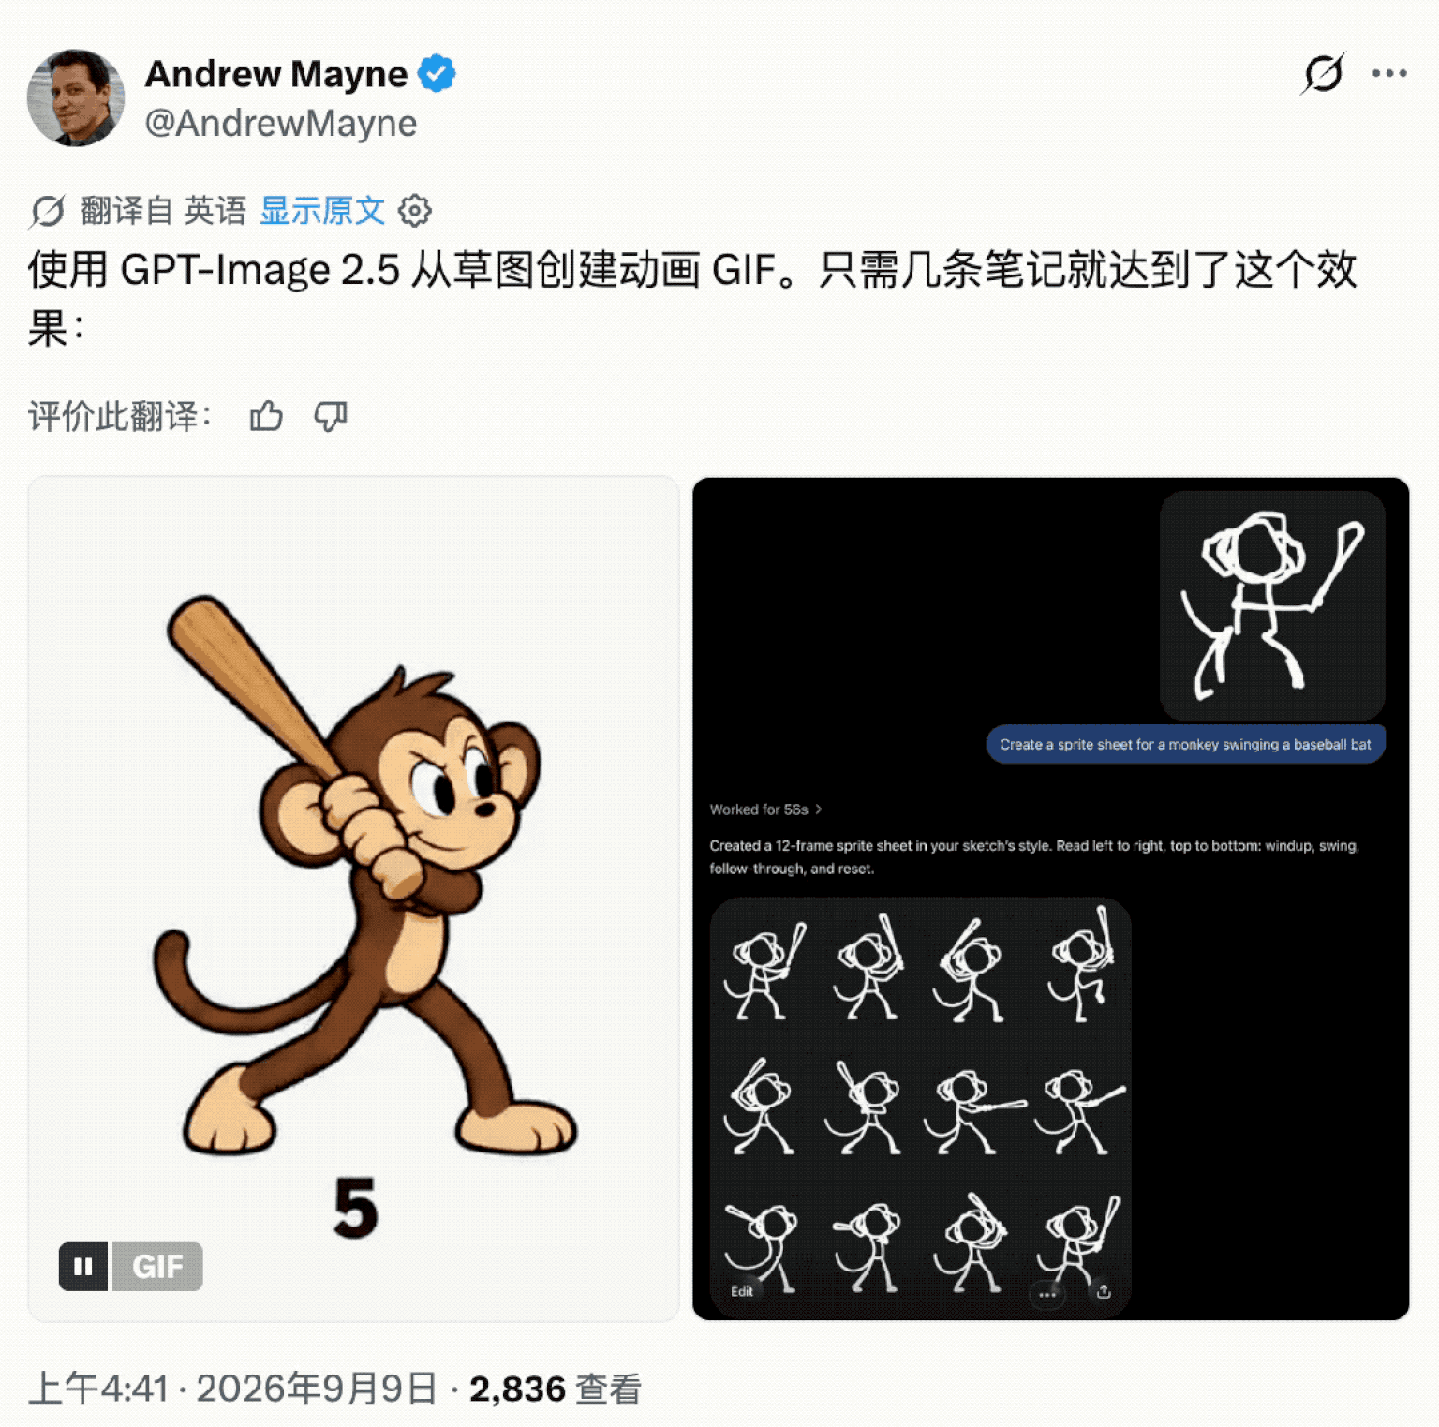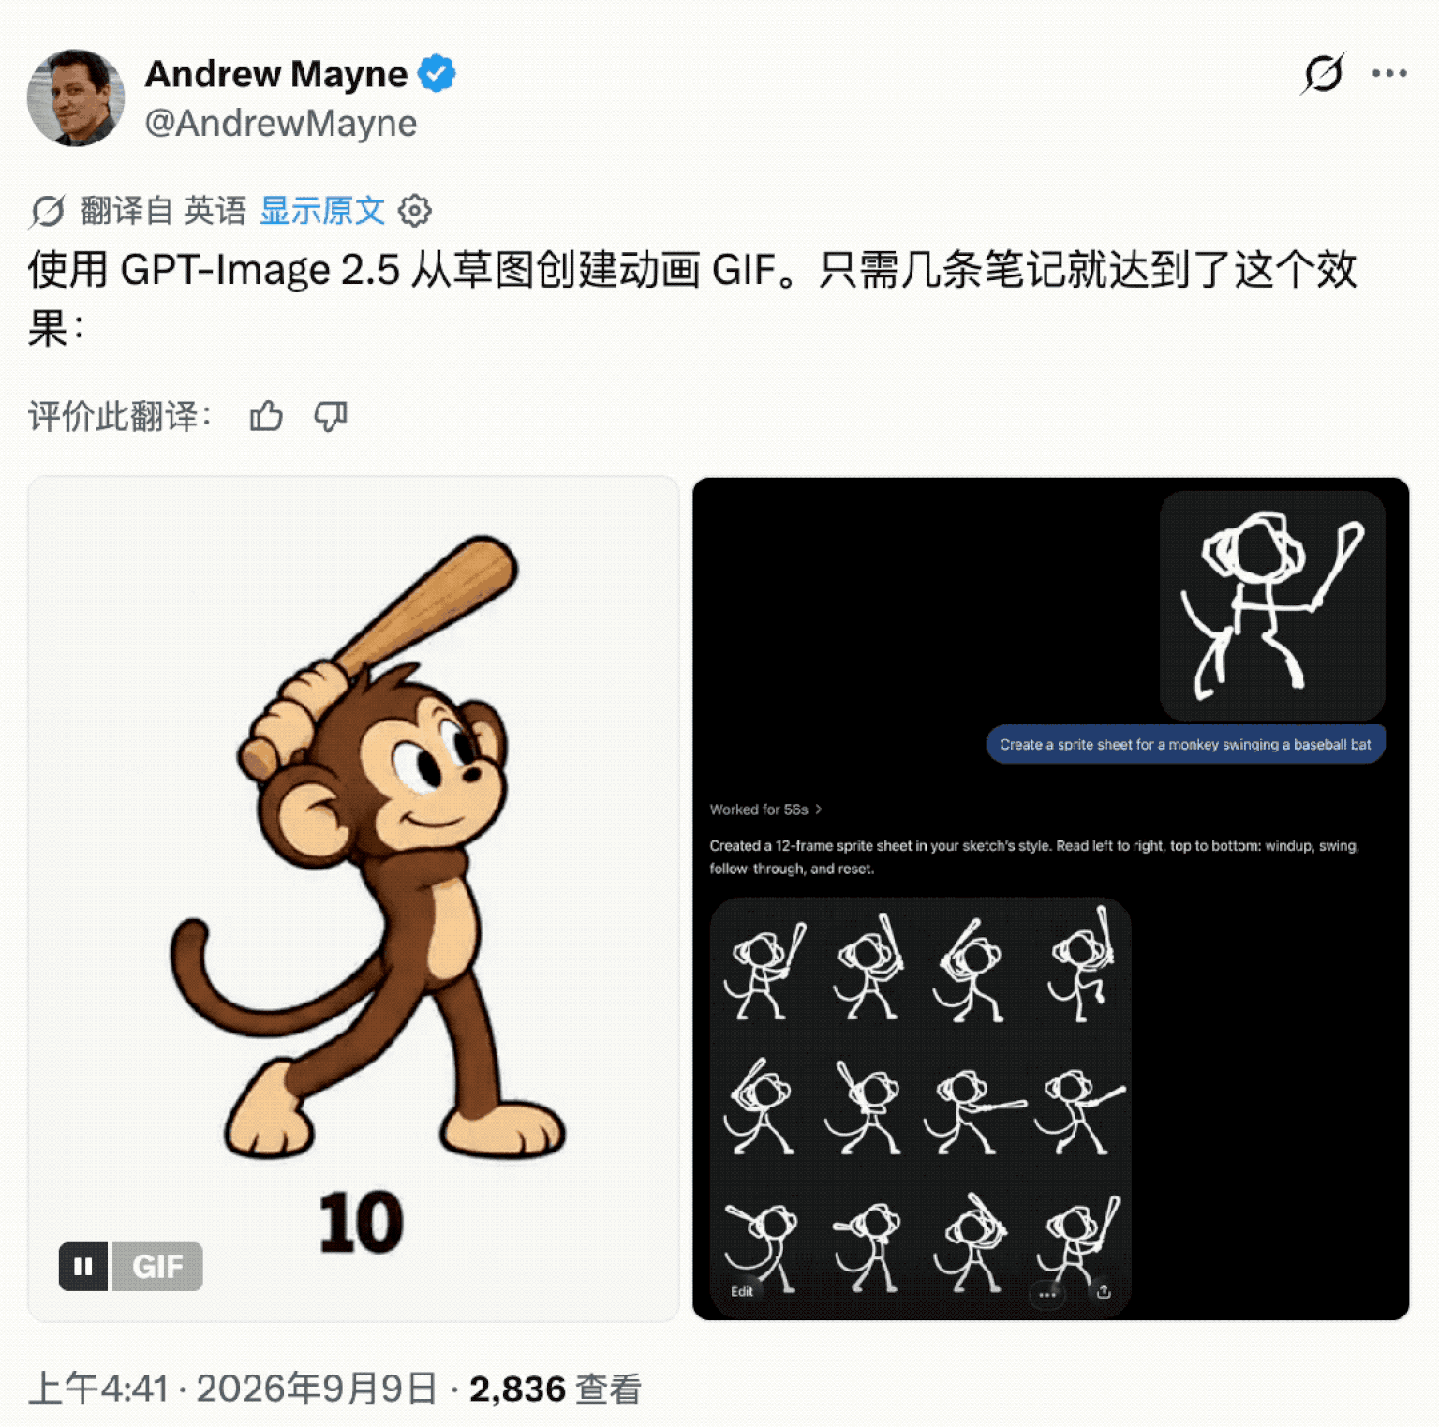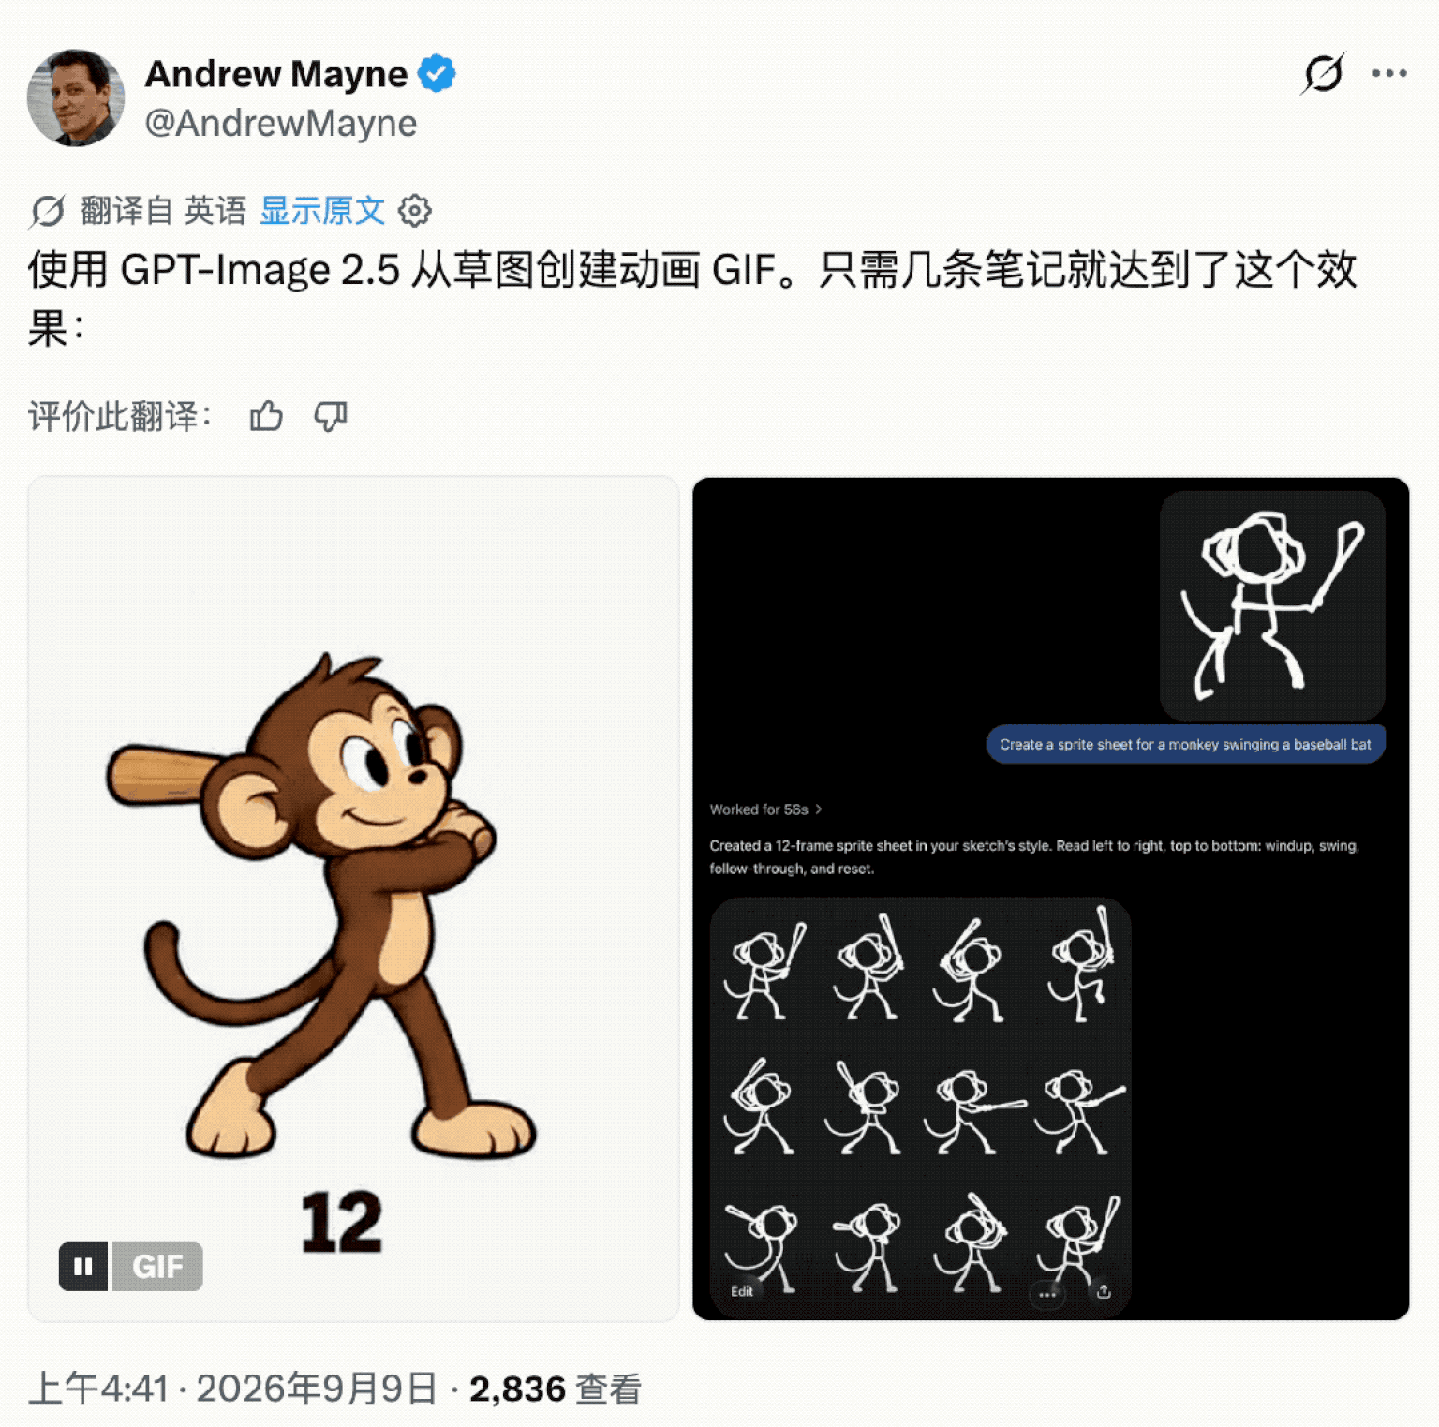
一个是 Sketch(草图),在移动端输入 @Sketch 之后,用户可以直接随手画出自己的想法,再让 GPT Image 根据草图继续生成。
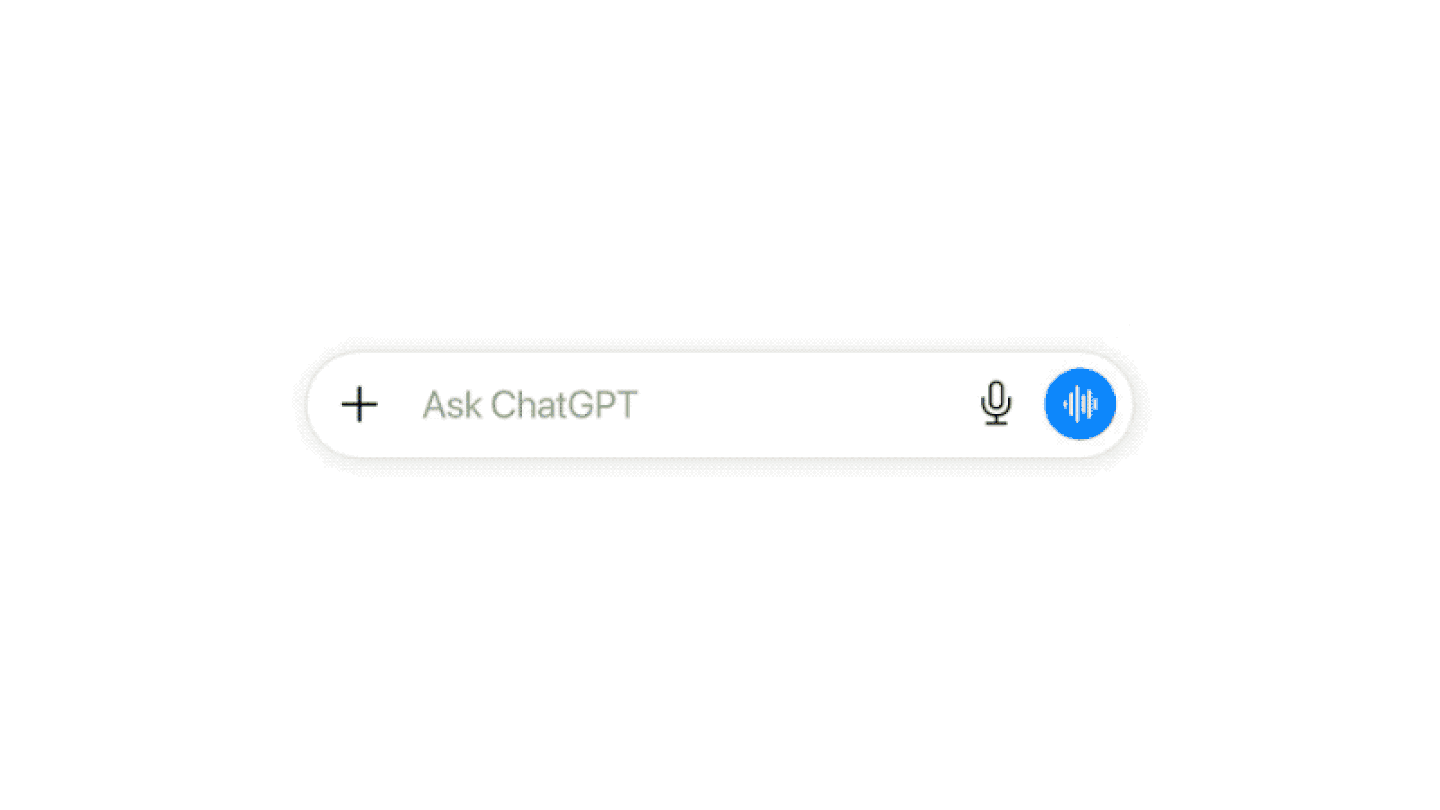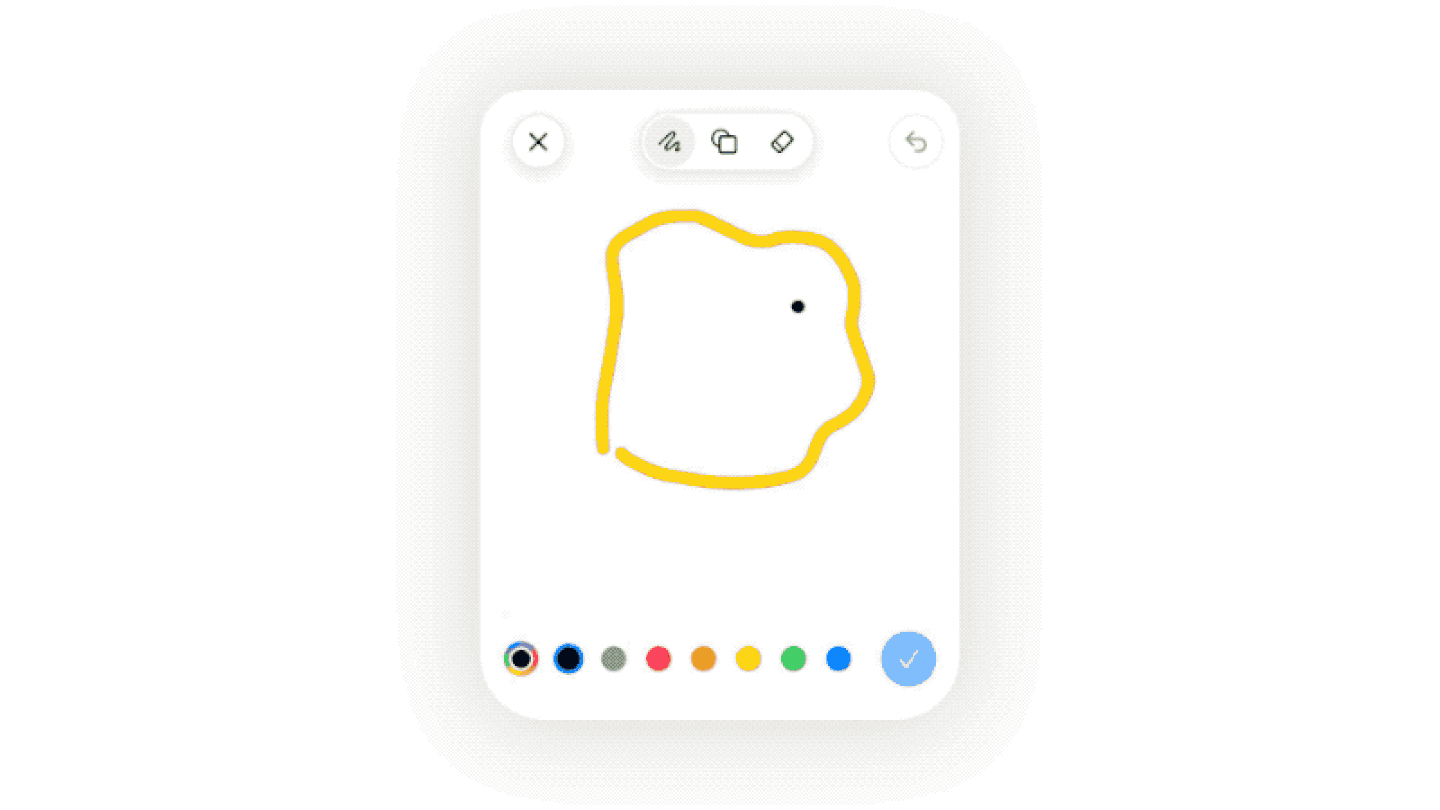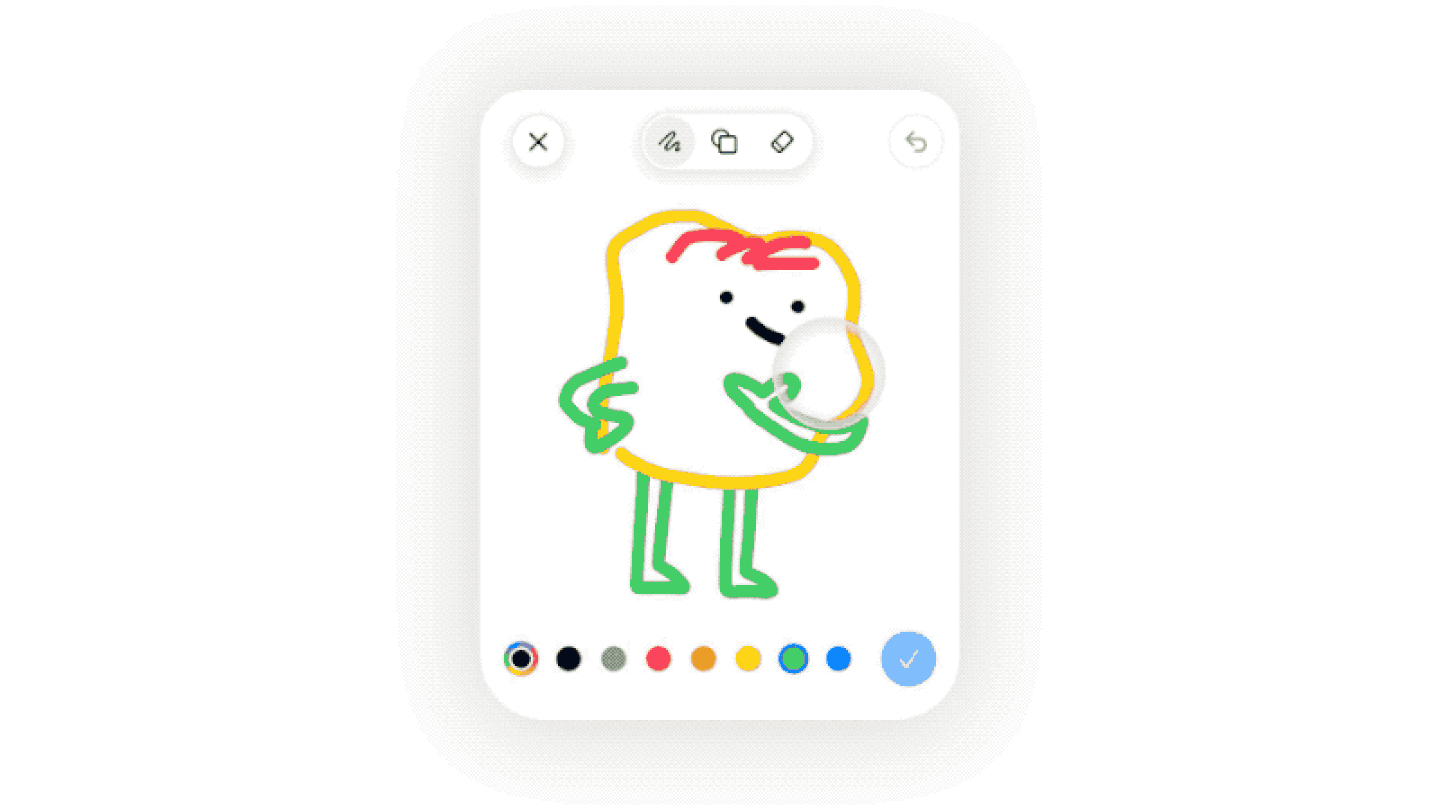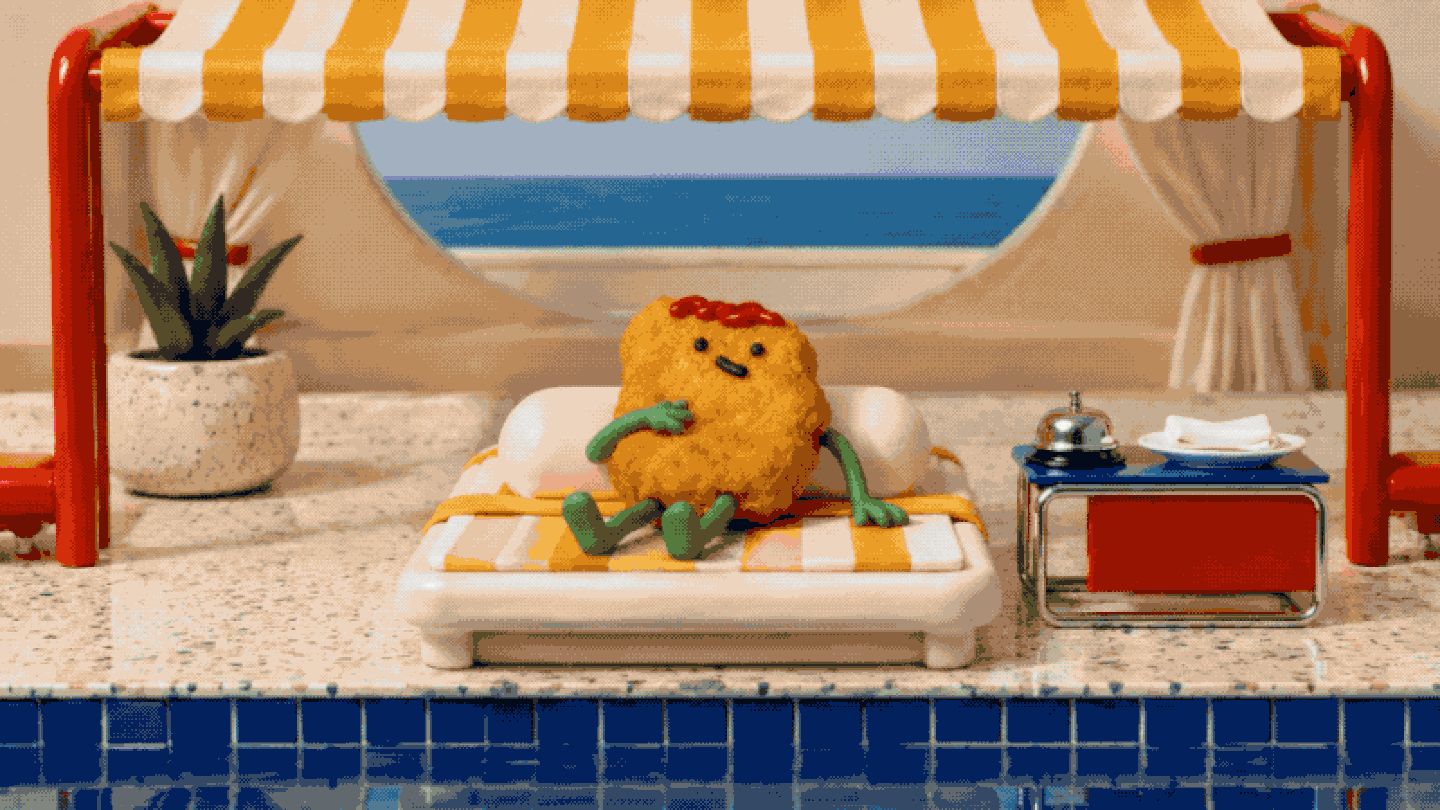
能画出来,就不用费劲描述。
不过这并不是什么新玩法,Nano Banana 能做,Adobe Firefly 能做,国内的腾讯混元、通义万相、Seedream 也早已支持线稿、涂鸦或者辅助线控制生成。
OpenAI 这次只是把这套已经很成熟的交互搬到了 GPT 里。
另一个功能则更像是在鼓励大家 「抄作业」,OpenAI 把它叫作 Pass your best ideas along。
现在分享一张 ChatGPT 生成的图片时,可以顺手把 Prompt 一起带出去,别人拿到后可以换上自己的照片和细节直接复刻。
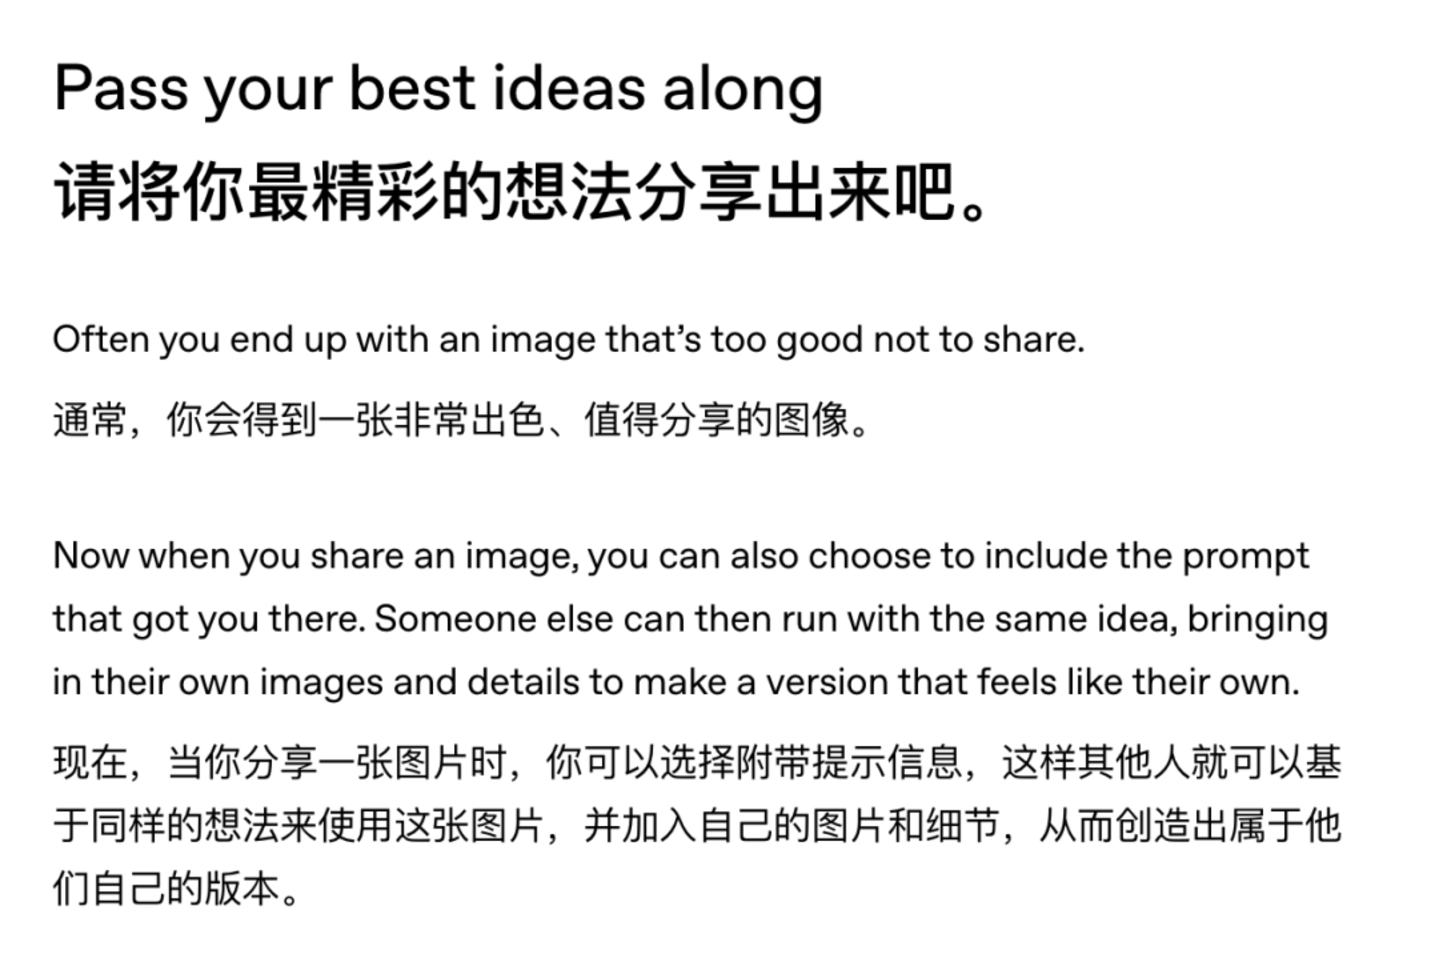
然而,Gemini 早就可以把包含 Prompt 和生成图片的完整对话分享出去,别人甚至可以直接接着这段对话继续生成;Nano Banana 后来还在 Google Messages 里做了 Remix,让好友围绕同一张图片来回接力修改。
OpenAI 还有得学呢……
网友怎么说
虽然前面在吐槽 OpenAI「补课」,但到了真正上手的时候,还是得承认一件事:GPT Image 2.5 确实是一款很强的生图模型。
发布之后,社群很快玩出了新花样。
目前传播最广的玩法,是用 Image 2.5 做定格动画。
开发者 Charlie Guo 拿 GPT Image 2.5 连续生成了一组画面,再把它们串成动画。这条帖子发布后浏览量迅速破万,并被多名 OpenAI 员工转发。

更进一步,还有人开始直接从草图生成动画素材。
比如下面这位网友,先随手画出一个拿着球棒的小猴子草图,再让 GPT Image 2.5 生成一整组动作连续的序列帧,最后拼成 GIF 动画。整个过程只需寥寥几笔,模型就能扩展成一个完整的 12 帧的 gif 动画。
做动画之外,还有一批人盯上了用 Image 2.5 生成透明底素材。
开发者 Konstantine 专门测试了 Sunburst 生成透明背景图的能力,认为它现在输出的透明底素材已经非常漂亮,并直接点名游戏开发者和设计师可能会拿它来做东西。
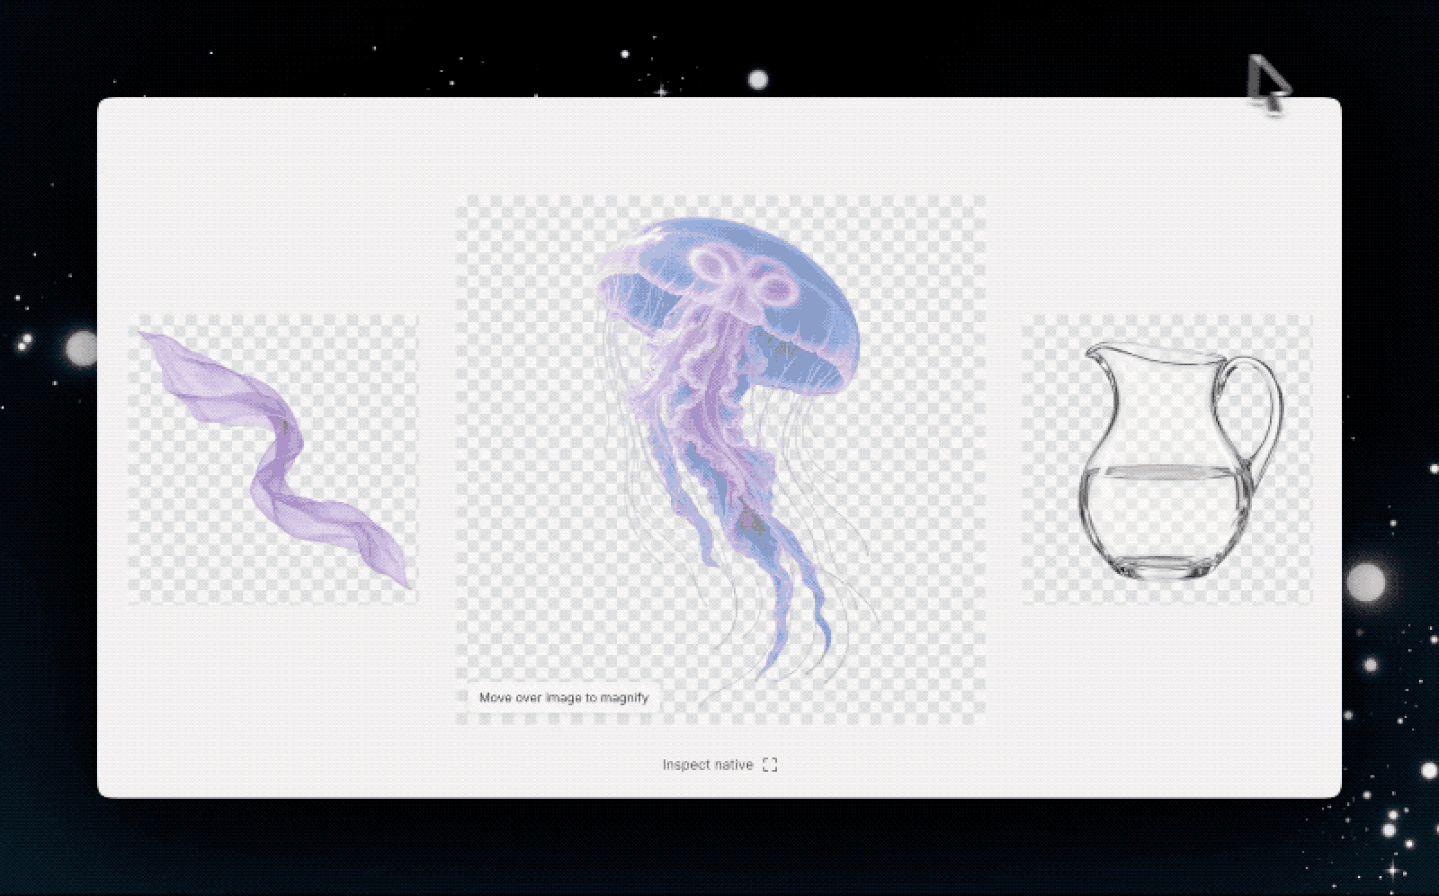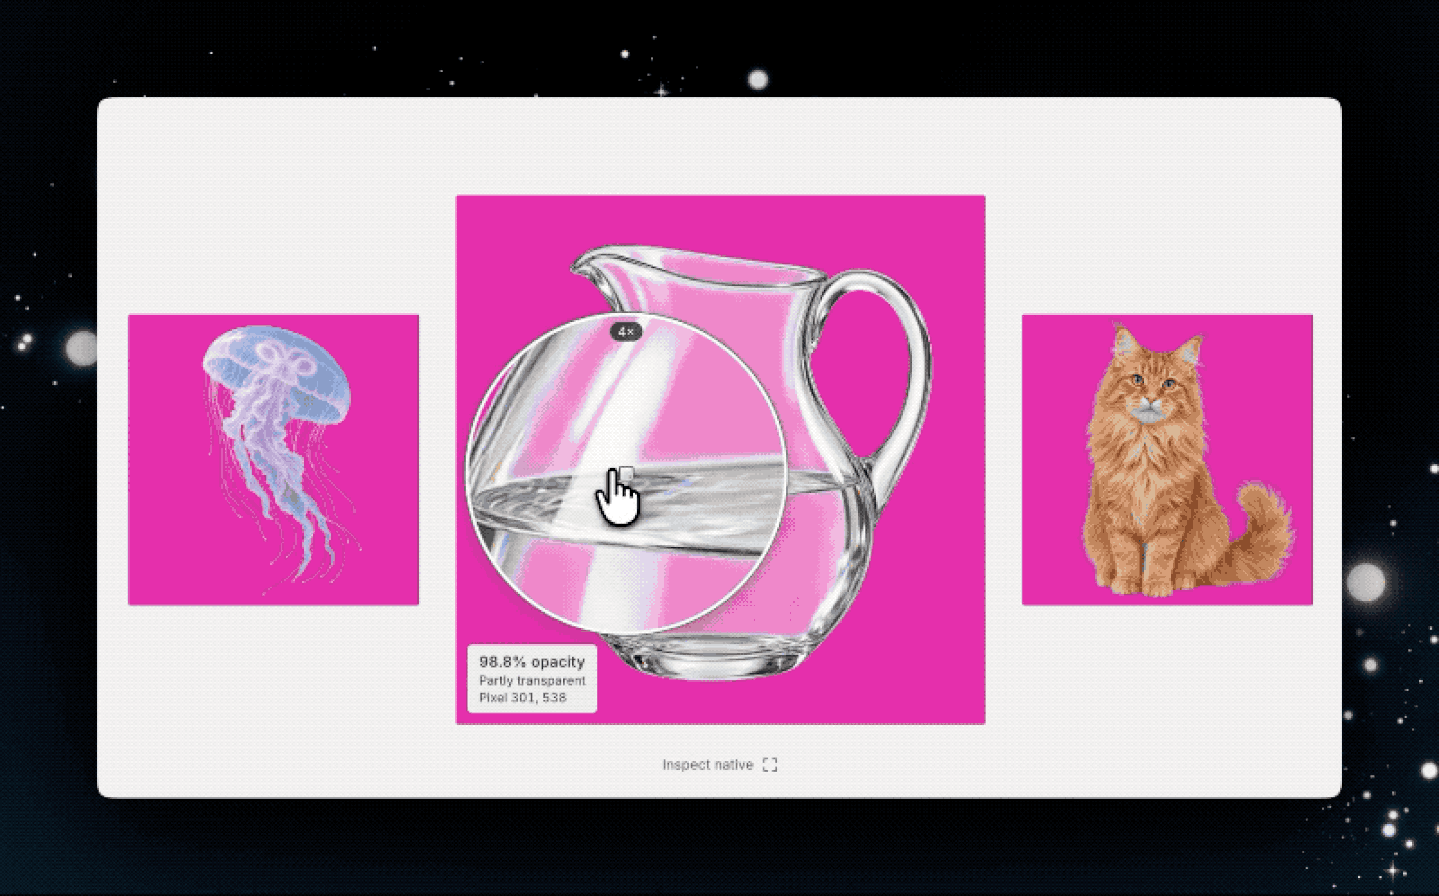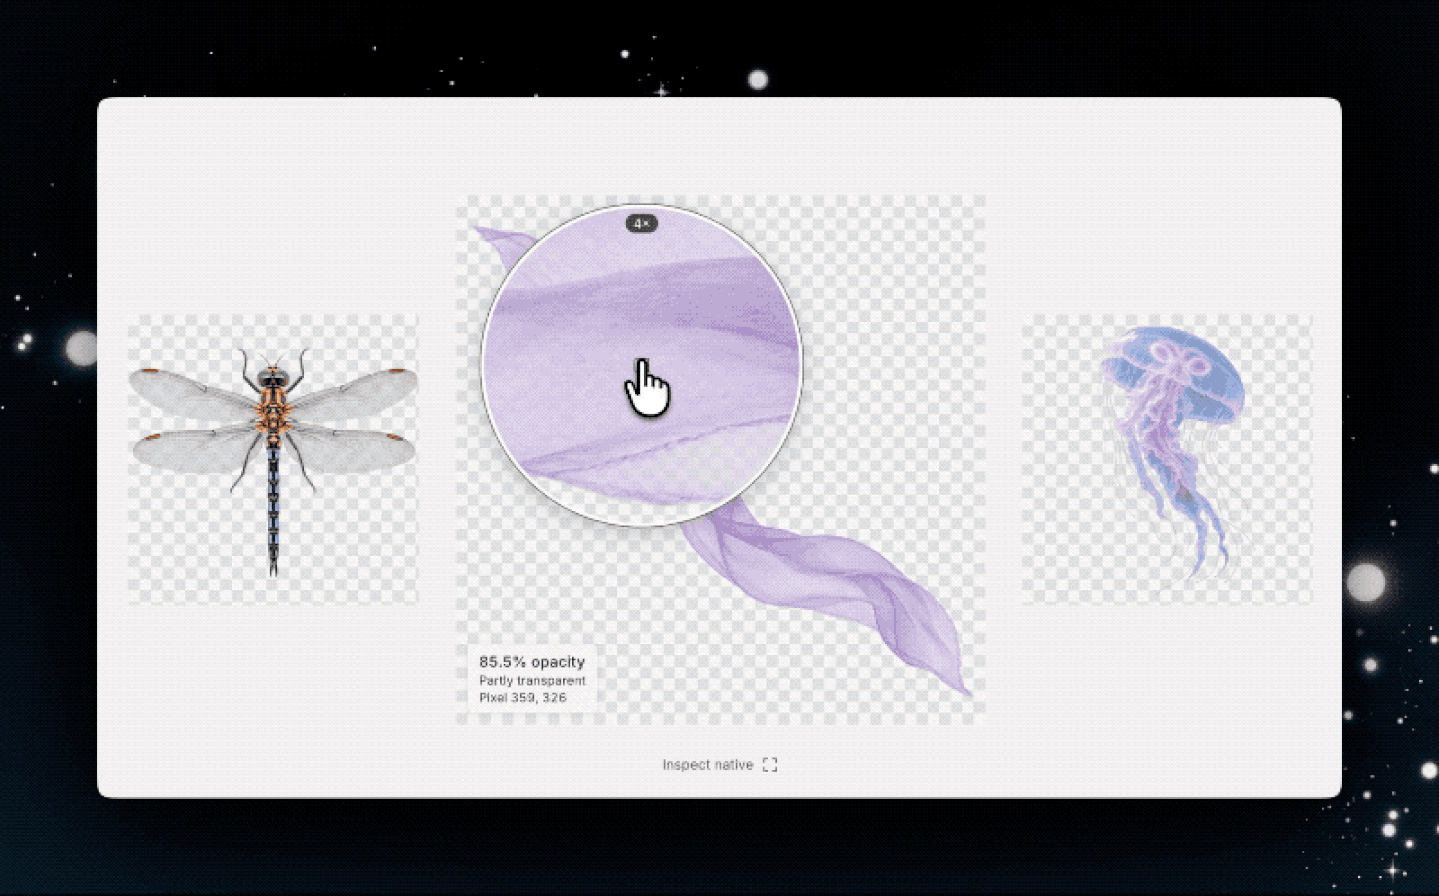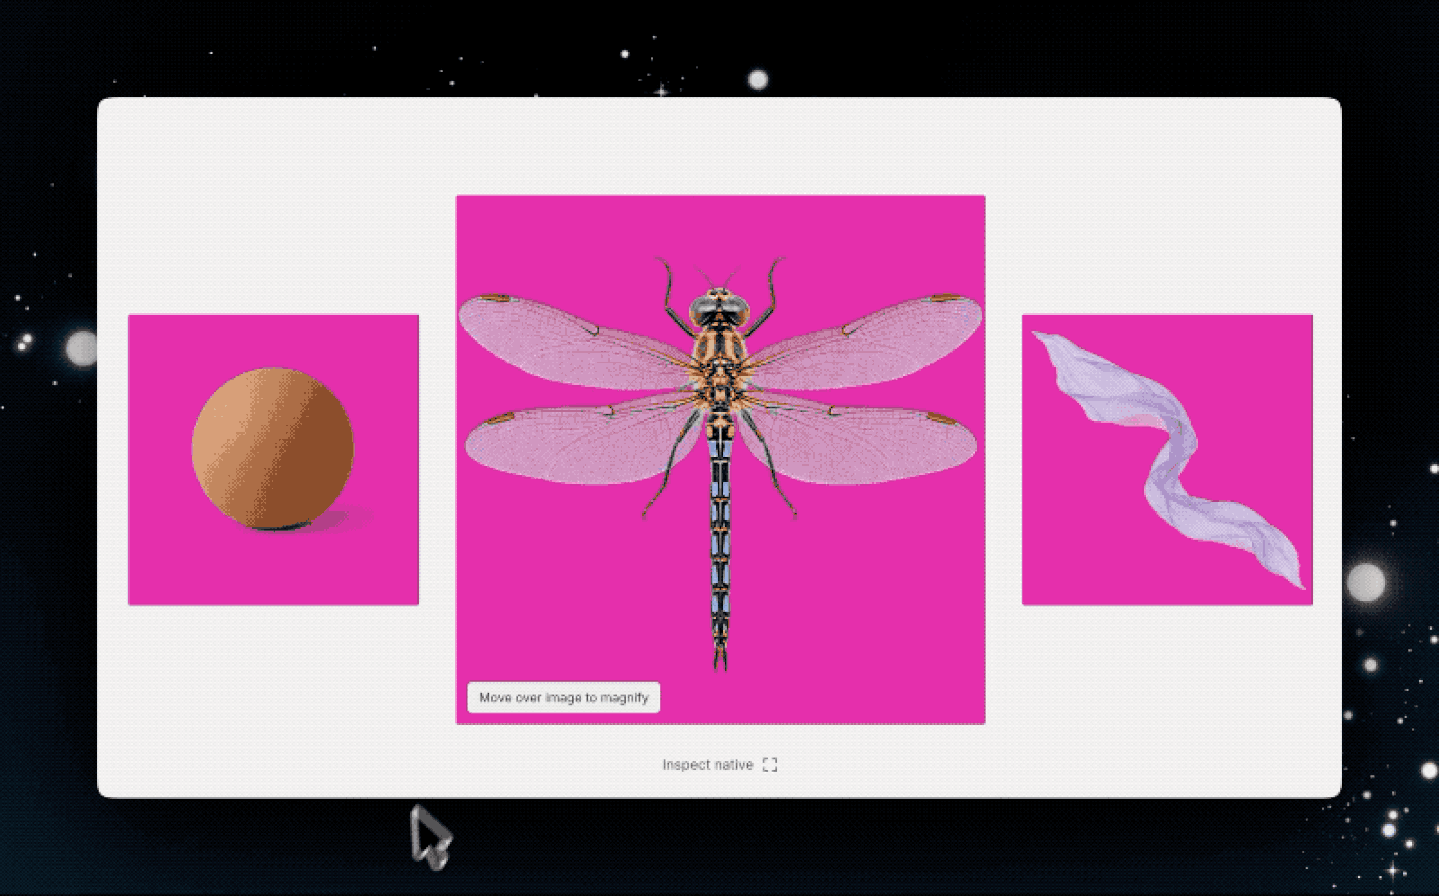
有了透明底,人物立绘、游戏道具、UI 图标、商品素材,就可以直接往网页、游戏或者设计稿里塞。
还有人开始暴力测试它的复杂指令理解。
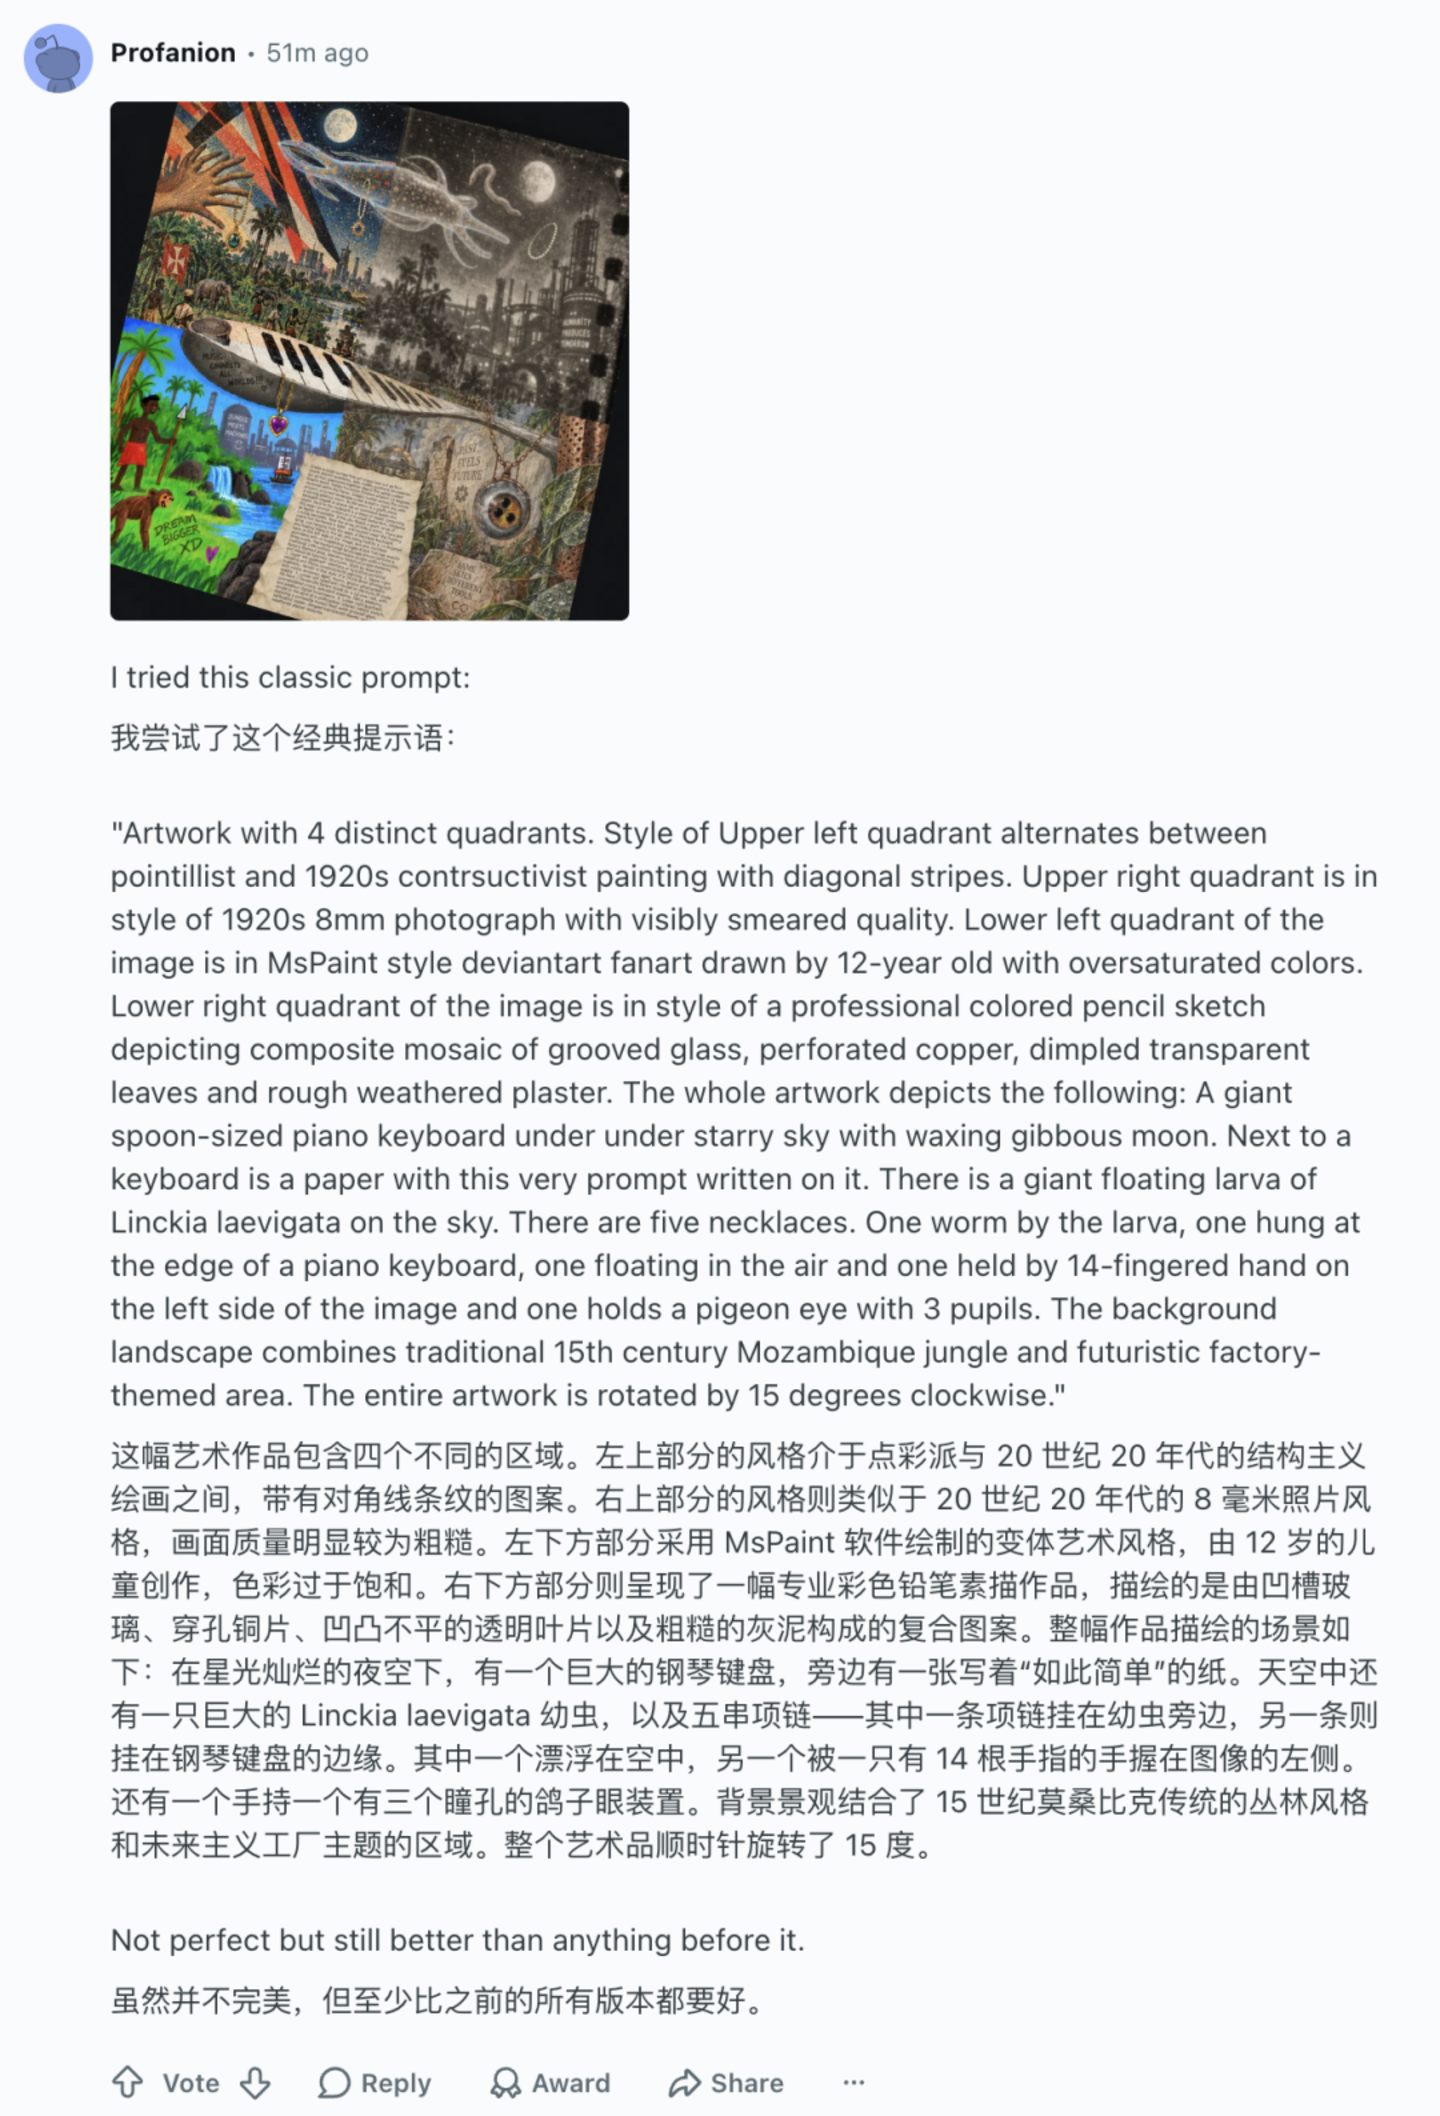
Reddit 上一名用户使用了一个近乎故意找茬的 Prompt:要求一张图同时出现四种画风、五条项链、14 根手指、三个瞳孔的鸽子眼睛,以及 15 世纪莫桑比克丛林和未来工厂。
结果……当然没有全部实现,但他的评价是:「不完美,但仍然比之前任何一次都好。」
一些更日常的变化也开始被用户注意到。
有人对比 Image 2 和 2.5 后认为,新模型的人物表情没那么僵,皮肤质感更自然;有人觉得画面透视、反射和构图明显更合理;还有人拿 Image 2 和 Image 2.5 用同一套提示词做了漫画,2.5 的分镜更活,角色表情更夸张,镜头远近和场景细节也会跟着剧情变化。相比之下,Image 2 更像把一组漂亮插画拼在一起。
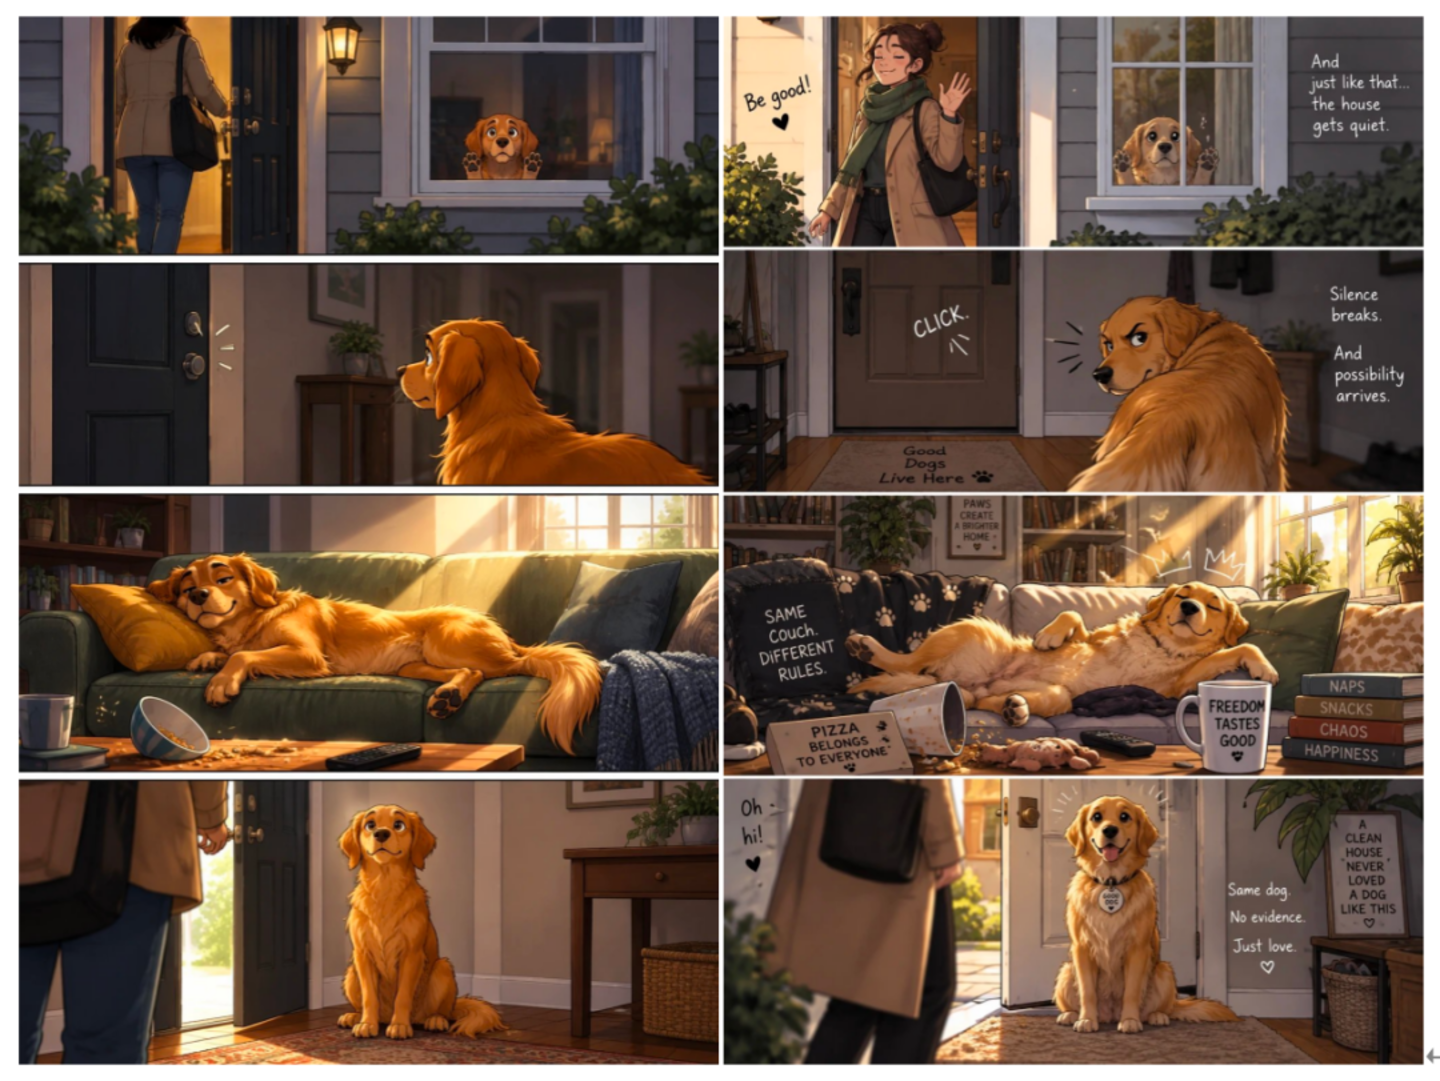
Image 2(左),Image 2.5(右)
对于真正把 AI 图片放进工作流的人,感受可能更加直接。
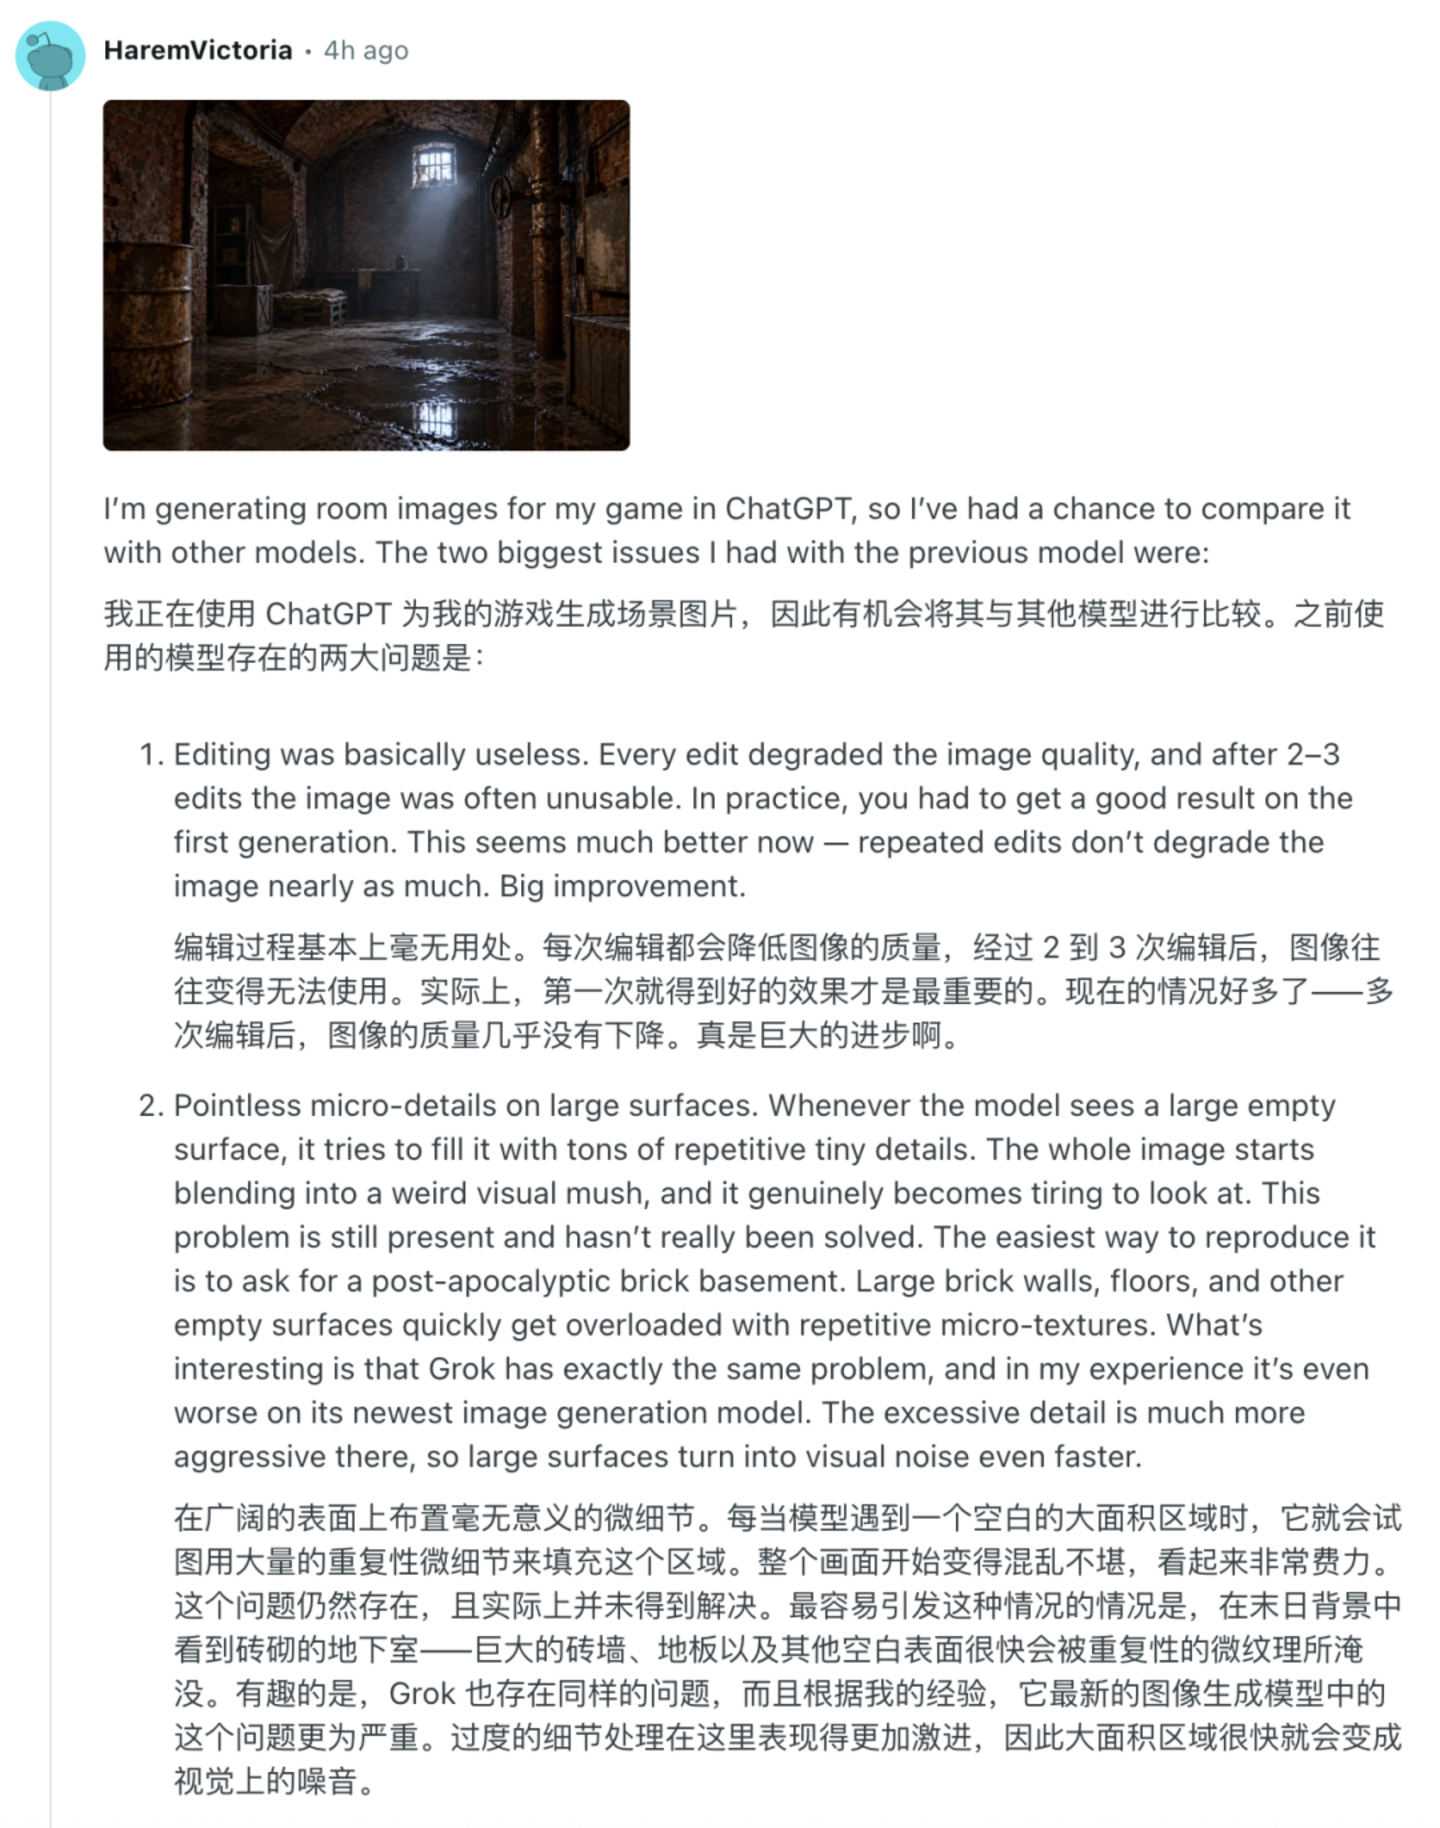
一名正在用 ChatGPT 给游戏制作房间素材的用户说,Image 2 最大的问题之一就是连续编辑两三次之后,图片往往已经劣化到不能用了,实际工作时基本等于必须第一轮就抽中满意结果。
换到 2.5 之后,他的评价是 「Big improvement」,反复修改造成的画质衰减明显少了。
当然,Image 2.5 也没有突然把所有老毛病一起治好,变成一个全能的完美生图模型。
目前也已经有人继续提到几个老问题::手偶尔还是会画坏;Image 2 时代就有人吐槽的棋盘格/高频噪声没有彻底消失;一些画面仍然会出现颗粒、像素化或者过度锐化。也有做 AI 商品摄影的用户认为,如果要求严格还原产品本身,NanoBanana 2 和 Pro 目前依然更可靠。
包括上面提到的游戏制作房间素材的用户,也表示他 「原以为自己可以放弃使用 Gemini 了」,但 「ChatGPT 和 Grok 中的过多微细节处理实在太过激进了」。
甚至在最基础的指令遵循上,社群评价也并不是一边倒。有用户认为尽管 2.5 的文字、细节和构图更好了,但复杂指令偶尔还是会被模型 「理解成另一个意思」。
GPT Image 2.5 没有重新发明 AI 生图,也没有在每一个维度上把 Nano Banana、Seedream 们甩在身后。
但 「别人早就有」 与 「它做得不够好」,显然是两码事。GPT Image 2 本来就很强,2.5 更像是在把过去明显的短板——编辑精度、多轮一致性和可持续修改——补得更完整了。
至少,对于 ChatGPT 庞大的用户群来说,现在用 GPT 生图可以少抽几次卡了。